1. 프로세스의 종료 과정 분석
프로세스는 크게 두 가지 흐름으로 종료됩니다.
• 유저 애플리케이션에서 exit() 함수를 호출할 때
• 종료 시그널을 전달받을 때
1.1 프로세스 종료 흐름 파악
커널에서 제공하는 do_exit() 함수를 실행하면 프로세스를 종료할 수 있습니다. do_exit() 함수에서 커널이 프로세스를 종료하는 코드를 분석하기에 앞서, do_exit() 함수가 어떤 흐름으로 호출되는지 살펴봅시다.
[process] [process]
[user space] ↓ exit [user space]
↓ 시스템 콜
[kernel space] | sys_exit_group [kernel space] → slow_work_pending
| do_group_exit kill do_work_pending
↓ do exit do_signal
do_group_exit
do_exit
1.1.1 exit() 시스템 콜 실행
위 그림의 왼쪽은 유저 공간에서 exit 시스템 콜을 발생시켰을 때 프로세스가 종료되는 흐름입니다.
보통 유저 프로세스가 정해진 시나리오에 따라 종료해야 할 때 exit() 함수를 호출합니다.
시스템 콜 발생 후, 해당 시스템콜 핸들러인 sys_group_exit() 함수가 호출되며, 이후 do_exit() 함수를 호출합니다.
1.1.2 종료 시그널을 전달받았을 때
위 그림의 오른쪽은 kill 시그널을 받아 프로세스가 소멸하는 흐름입니다. 유저 프로세스 뿐만 아니라 커널 프로세스도 커널 내부에서 종료 시그널을 받으면 소멸합니다. 참고로, 커널 함수로 send_signal() 함수를 호출하면 특정 프로세스에게 종료 시그널을 전달할 수 있습니다. 종료 시그널을 받은 프로세스는 do_exit() 함수를 실행해 소멸됩니다.
do_exit() 함수로 커널이 프로세스를 종료시키는 세부 동작 못지않게, 프로세스가 종료되는 흐름을 파악하는 것이 중요합니다.
유저 애플리케이션 프로세스나 커널 프로세스가 예외 상황에서도 의도치 않게 종료해서 문제가 발생하는 경우가 있기 때문입니다.
프로세스가 종료될 때 처리되는 흐름을 알면, 이런 문제를 만났을 때 커널의 어느 함수부터 분석해야 할지 결정할 수 있습니다.
1.2 do_exit() 함수 분석
do_exit() 함수는 '종료를 실행한다'는 동작을 하며, 주체는 프로세스입니다.
1.2.1 do_exit() 함수 선언부와 인자 확인
먼저 함수 인자 code를 살펴보죠. code는 프로세스 종료 코드를 뜻합니다.
터미널에 'kill -9 [pid]' 라는 명령어를 입력해 프로세스를 종료하면 code 인자로 9가 전달됩니다.
TRACE32로 do_exit() 함수를 호출했들 때의 콜스택 정보입니다.
'kill -9 [PID}' 명령어의 -9가 exit_code 인자로 9가 전달된 것입니다.
함수 선언부 왼쪽엔 __noreturn 키워드가 있는데, 이 지시자는 실행 후 자신을 호출한 함수로 되돌아가지 않는다는 뜻입니다.
다른 관점에서 보면 커널 코드를 실행하는 주인공인 프로세스가 종료되니 당연히 이전 함수로 되돌아가지 못하죠. 그래서 반환값은 없습니다.
do_exit() 함수는 프로세스에 대한 리소스를 정리하고 do_task_dead() 함수를 호출한 후 schedule() 함수를 실행합니다. do_exit() 함수를 끝까지 실행하지 않아서 __noreturn 키워드를 지정한 것이죠.
프로세스는 자신의 프로세스 스택 메모리 공간을 해제할 수 없습니다. 프로세스를 해제하는 동작인 do_exit() 함수를 stack 메모리 공간에서 실행하기 때문에, do_task_dead()와 schedule() 함수를 호출하여 스케줄링 한 후 '다음에 실행되는 프로세스'가 종료되는 프로세스의 스택 메모리 공간을 해제시켜 줍니다.
1.2.2 do_exit() 함수의 동작 방식 확인
1) init 프로세스가 종료하면 강제 커널 패닉 유발: 보통 부팅 과정에서 발생
2) 이미 프로세스가 do_exit() 함수의 실행으로 프로세스가 종료되는 도중 다시 do_Exit() 함수가 호출됬는지 점검
3) 프로세스 리소스(파일 디스크립터, 가상 메모리, 시그널) 등을 해제
4) 부모 프로세스에게 자신이 종료되고 있다고 알림
5) 프로세스의 실행 상태를 task_struct 구조체의 state 필드에 TASK_DEAD로 설정
6) do_task_dead() 함수를 호출해 스케줄링을 실행
- do_task_dead() 함수에서 __schedule() 함수가 호출되어 프로세스 자료구조인 태스크 디스크립터와 스택 메모리를 해제
1.2.3 do_exit() 함수 코드 분석
void __noreturn do_exit(long code)의 리팩토링 결과
void __noreturn make_task_dead(int signr)
* 이 작업을 그대로 두고 재부팅을 기다리는 것입니다.
리눅스 커널의 안정성 강화와 상태 관리의 단순화라는 큰 흐름 속에서 일어난 아키텍처 리팩토링입니다.
결론부터 말씀드리면, do_exit()가 레거시(Legacy)라서 옮겨간 것이 아니라, "정상적인 종료"와 "비정상적인 강제 종료(Fatal Fault)"의 역할을 엄격히 분리하기 위함입니다.
(1) do_exit()에서 make_task_dead()로의 리팩토링 시점
이 변화는 리눅스 커널 5.17 버전에서 본격적으로 도입되었습니다.
• 배경: 이전 버전까지는 커널 내에서 치명적인 예외(Oops, Panic 등)가 발생했을 때 하드웨어 아키텍처별로 do_exit()를 직접 호출하거나 제각각 처리하는 방식이었습니다.
• 변화: 5.17 버전에서 Eric W. Biederman에 의해 프로세스의 '정상 종료'와 '비정상적 강제 종료'를 명확히 구분하는 패치가 병합되었습니다.
• 이유: do_exit()는 자원을 해제하는 복잡한 로직이 많아, 이미 커널이 오염된 상태(Recursive Fault)에서 호출하면 시스템을 더 위험하게 만들 수 있었기 때문입니다. 따라서 오직 "죽이는 것"에만 집중하는 make_task_dead()가 표준 API로 자리 잡았습니다.
(2) 왜 make_task_dead()로 옮겨갔는가? (The "Recursive Fault" Trap)
기존에는 프로세스가 죽을 때 무조건 do_exit()를 통과했습니다. 하지만 여기서 치명적인 문제가 발생합니다.
• 문제 상황: 프로세스가 종료되는 도중(do_exit 수행 중)에 또다시 커널 패닉이나 폴트(Fault)가 발생하면?
• 무한 루프: 커널은 이 폴트를 잡으려고 다시 do_exit()를 호출합니다. 그러면 또 폴트가 나고... 결국 시스템은 재귀적 폴트(Recursive Fault)에 빠져 완전히 먹통이 됩니다.
[리팩토링의 핵심] 그래서 커널 개발자들은 do_exit()는 "일반적인 프로세스 종료 절차"로 남겨두고, 시스템이 도저히 복구 불가능한 치명적 오류를 만났을 때는 make_task_dead()라는 별도의 '비상구'를 만든 것입니다.
(3) do_exit()는 레거시인가?
아닙니다. do_exit()는 여전히 리눅스 커널 프로세스 관리의 Mainstream입니다.
• do_exit(): 파일 디스크립터 정리, 메모리 반환, 부모 프로세스에 시그널 전송 등 '깔끔한 뒷정리'를 담당합니다.
• make_task_dead(): 하드웨어 폴트, OOPS, 커널 패닉 등 '뒷정리고 뭐고 일단 시스템을 살려야 하는 상황'에서 호출되는 응급실입니다.
(5) 코드의 의미 분석: "최후의 방어선"
코드는 "이미 죽어가고 있는데 또 사고가 터진 상황"을 처리합니다.
• PF_EXITING 체크: 이 플래그가 이미 서 있다는 건 do_exit()가 돌다가 터졌다는 뜻입니다.
• do_task_dead(): 여기서 가장 중요한 건, 더 이상 자원을 해제하려고 시도하지 않는다는 것입니다. "더 건드리면 시스템 전체가 깨지니, 이 태스크는 그냥 좀비처럼 버려두고(Wait for reboot) 멈춰라"라는 의미입니다.
(6) 왜 6.1에서는 이 코드가 더 간결해 보일까?
위의 코드 조각은 일종의 "Fail-safe(안전 장치)"입니다.
• refcount_inc(&tsk->rcu_users);: 이 부분이 6.1에서 매우 중요합니다. 프로세스가 죽더라도 해당 메모리(task_struct)가 RCU 콜백에 의해 바로 해제되지 않도록 보장하여, 시스템이 리부트되기 전까지 최소한의 정보를 유지하게 합니다.
• 결론: 6.1은 과거의 복잡한 플래그 기반 제어(PF_EXITPIDONE 등)를 버리고, 참조 카운트(Refcount)와 상태 값(Exit State) 위주의 현대적인 리소스 관리 방식을 택한 것입니다.
(7) 시스템적 통찰
이 변화는 리눅스 커널이 점점 더 "고가용성(High Availability)"을 중시하도록 진화했다는 증거입니다.
• 임베디드 관점: 만약 시스템에서 특정 프로세스가 죽는데, 재귀 폴트로 커널 전체가 뻗어버리면 안 되겠죠? make_task_dead()는 해당 프로세스만 안전하게(?) 고립시키고 시스템은 어떻게든 돌아가게 만드는 장치입니다.
• 버전 간 차이: 예전 커널 소스를 보셨다면 do_exit() 하나만 있었겠지만, 최신(v6.x)으로 오면서 이처럼 예외 상황에 대한 격리가 훨씬 정교해졌습니다.
결론: 핵심 포인트
이 코드는 "시스템 프로그래머라면 에러 핸들링을 어떻게 계층화해야 하는가"에 대한 교과서적인 예시입니다.
1. 정상 경로는 do_exit()
2. 치명적 오류/재귀 오류 경로는 make_task_dead()
이제 이 태스크가 do_task_dead()를 타고 스케줄러로 넘어가면, schedule() 함수가 이 녀석을 다시는 실행 리스트에 넣지 않게 됩니다.
PF_EXITPIDONE 플래그의 행방
결론부터 말씀드리면, PF_EXITING과 PF_EXITPIDONE은 서로 역할이 완전히 다른 플래그입니다. 6.1 버전에서 PF_EXITPIDONE이 보이지 않는 것은 기능이 PF_EXITING으로 합쳐진 것이 아니라, 프로세스 종료 상태 머신이 정교화되면서 해당 플래그의 필요성이 사라졌기 때문입니다.
두 플래그의 결정적인 차이점을 전문가의 시각에서 분석해 드릴게요.
(1) /kernel/signal.c의 PF_EXITPIDONE플래그는 어디로 갔나?
PF_EXITPIDONE 플래그가 사라진 것은 리눅스 커널 5.15 즈음부터 진행된 태스크 종료 플래그 정리 작업의 결과입니다.
• 사라진 이유: 과거에는 프로세스가 완전히 종료되어 PID를 반납할 수 있는 상태임을 나타내기 위해 이 플래그를 썼습니다. 하지만 커널이 발전하면서 tsk->exit_state (예: EXIT_DEAD, EXIT_ZOMBIE)만으로도 해당 상태를 충분히 판단할 수 있게 되었습니다.
• 6.1 버전의 상태: 6.1 버전에서는 중복되거나 모호한 플래그를 줄이고, task_struct의 상태 머신을 더 엄격하게 관리합니다. PF_EXITPIDONE이 하던 역할은 이제 EXIT_DEAD 상태 설정과 RCU를 통한 구조체 해제 메커니즘이 대신하게 되었습니다.
(2) PF_EXITING vs PF_EXITPIDONE (역할의 차이)
| 플래그 | 의미 (Semantic) | 설정 시점 | 주요 역할 |
| PF_EXITING | "나 이제 죽으러 간다" | do_exit() 진입 직후 | 프로세스가 종료 절차를 시작했음을 알림. 추가적인 시그널 전달이나 자원 할당을 차단함. |
| PF_EXITPIDONE | "내 PID는 이제 끝났다" | do_exit()의 아주 마지막 단계 | 프로세스가 거의 모든 자원을 해제하고, PID 해시 테이블 등에서 제거되었음을 알림. |
• PF_EXITING (진행 중): "공사 중" 표지판과 같습니다. 다른 프로세스가 이 녀석에게 말을 걸거나(Signal), 뭔가 부탁하려고 할 때 "나 지금 나가는 중이야, 방해 마"라고 알려주는 역할입니다.
• PF_EXITPIDONE (완료 직전): 4.19 등 과거 커널에서 사용되던 플래그로, "이제 이 녀석은 이름(PID)도 사라졌으니 아무도 찾을 수 없다"는 최종 확정 도장이었습니다.
(3) 6.1 버전에서 왜 PF_EXITPIDONE이 사라졌나?
6.1 버전을 포함한 최신 커널에서는 task_struct의 exit_state와 RCU(Read-Copy-Update) 메커니즘이 훨씬 정교해졌습니다.
1)상태 값의 명확화: 과거에는 플래그(flags)로 종료 단계를 체크했다면, 이제는 tsk->exit_state가 EXIT_ZOMBIE인지 EXIT_DEAD인지만 보고도 PID 반납 여부를 확실히 알 수 있습니다.
2) RCU 지연 해제: 프로세스가 죽어도 task_struct 구조체 자체는 RCU grace period가 지날 때까지 메모리에 남아있습니다. 즉, "플래그"로 살아있는지 확인하지 않아도, RCU가 메모리 안전성을 보장해주기 때문에 굳이 PF_EXITPIDONE 같은 세세한 플래그로 보호할 필요가 줄어든 것입니다.
4) /kernel/signal.c에서의 맥락 (*포인트)
signal.c에서 PF_EXITING을 체크하는 이유는 명확합니다.
• Race Condition 방지: 어떤 프로세스가 죽어가고 있는데(PF_EXITING), 동시에 다른 CPU에서 이 프로세스에 시그널을 보내려고 하면 어떻게 될까요?
• 커널의 선택: PF_EXITING이 서 있다면 시그널 전달을 즉시 중단합니다. 죽어가는 놈에게 시그널을 줘봤자 처리할 signal_handler도 이미 해제되었을 가능성이 크기 때문입니다.
5) 핵심 요약: 4.19 vs 6.1 대조
• 4.19: PF_EXITING으로 시작을 알리고, 마지막에 PF_EXITPIDONE으로 마침표를 찍음.
• 6.1: PF_EXITING으로 시작을 알리는 것은 동일하나, 마침표는 PF_EXITPIDONE 플래그 대신 exit_state = EXIT_DEAD 설정과 RCU 해제 로직이 담당함.
결론적으로, 두 플래그는 동일하지 않습니다. 6.1에서 PF_EXITING을 보신다면 그것은 여전히 "종료 절차의 시작"을 의미할 뿐이며, PF_EXITPIDONE의 빈자리는 커널의 더 단단해진 상태 관리 로직이 채우고 있다고 이해하시면 완벽합니다.
exit_signals(tsk)는 task_struct 구조체의 flags 필드를 PF_EXITING으로 바꿉니다. 종료할 프로세스가 처리할 시그널이 있으면 retarget_shared_pending() 함수를 실행해 시그널 대신 처리할 프로세스를 선정합니다.
exit_mm(); 함수는, 프로세스의 메모리 디스크립터인 mm_struct 구조체의 리소스를 해제하고 메모리 디스크립터의 사용 카운터를 1만큼 감소시킵니다.
exit_files(tsk);와 exit_fs(tsk); 는 프로세스가 사용하고 있는 파일 디스크립터 정보를 해제합니다.
exit_notify(tsk, group_dead); 는 부모 프로세스에게 현재 프로세스가 종료 중이라는 사실을 통지합니다.
마지막으료 do_task_dead() 함수를 호출합니다.
부팅 도중 init 프로세스가 종료되는 경우가 있습니다. 이 떄 다음과 같은 커널 로그와 함께 커널 패닉이 발생합니다.
유저 프로세스의 부모 프로세스가 종료되면 누가 부모 프로세스의 역할을 대신할까요? 바로 init 프로세스가 대신 부모 프로세스가 됩니다. init 프로세스는 유저 레벨 프로세스릉 생성하며 관장하는 역할을 수행합니다.
그런데, init 프로세스가 종료된다면 시스템은 정상적으로 동작할 수 없는 심각한 상황입니다. init 프로세스가 불의의 상황으로 종료되면 강제로 커널 패닉을 발생시킵니다.
보통 리눅스 커널 버전을 업그레이드 한 수 root file system이나 시스템을 초기화 하는 데 필요한 디바이스 노드를 생성하지 못했을 때 init 프로세스가 종료됩니다.
1.3 do_task_dead() 함수 분석
/kernel/sched/core.c
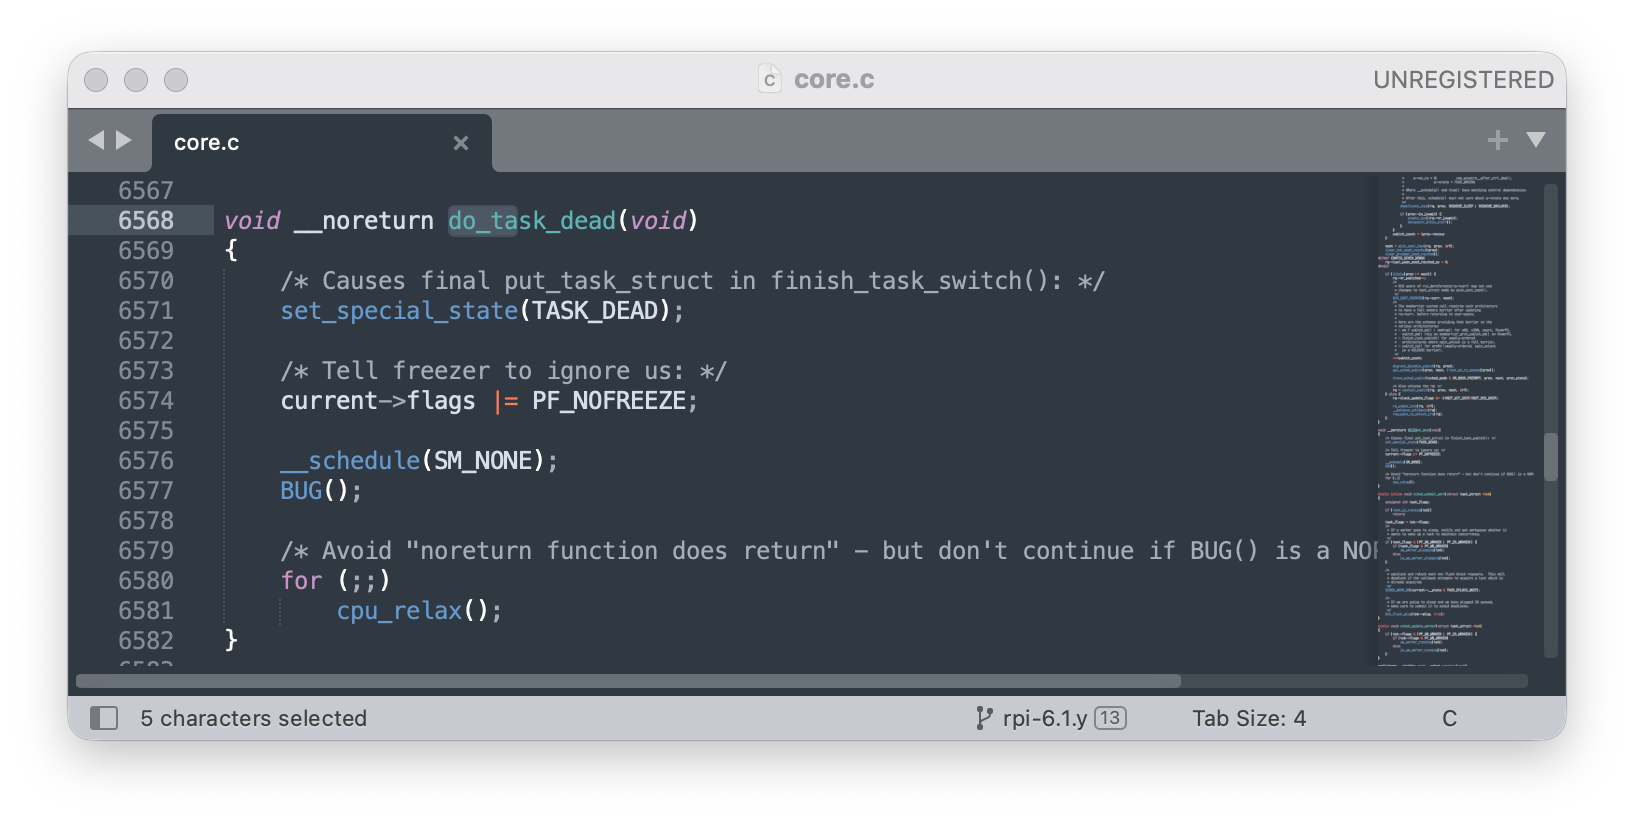
set_special_State(TASK_DEAD); 함수를 호출해 프로세스의 상태를 TASK_DEAD 플래그로 바꿉니다.
current->flags |= PF_NOFREEZE; 를 통해, 프로세스 태스크 디스크립터의 flags 필드에 PF_NOFREEZE 플래그를 OR 연산으로 적용합니다.
※ current는 현재 실행중인 프로세스 태스크 디스크립터 자료구조, task_struct 구조체 타입입니다.
__schedule(SM_NONE); 함수를 호출해 스케줄링을 요청합니다. SM_NONE을 전달하는 이유는 선점 스케줄링을 실행하지 않겠다는 뜻입니다.
__schedule(false)
__schedule(SM_NONE)
__schedule() 함수의 인자값이 false/true (boolean)에서 SM_NONE과 같은 enum sched_mode 타입으로 변경된 것은 리눅스 커널 5.14 버전부터입니다.
경력직 엔지니어로서 이 변화의 '배경'과 '설계 의도'를 이해하는 것은 매우 중요합니다. 단순히 값이 바뀐 게 아니라, 스케줄러의 동작 모드를 명확히 구분하기 위한 아키텍처 개선이기 때문입니다.
(1) 리팩토링의 시점과 이유
• 변경 버전: Linux Kernel 5.14 (2021년 8월 병합)
• 이유 (Type Safety & Readability): * 기존에는 __schedule(bool preempt) 형태였습니다. true면 선점(preempt), false면 비선점(non-preempt) 모드였죠.
• 하지만 커널이 복잡해지면서 단순히 true/false만으로는 스케줄링이 발생하는 다양한 맥락(Context)을 다 담기 어려워졌습니다.
• 특히 do_task_dead()나 io_schedule()처럼 특수한 상황에서 호출되는 스케줄링의 의도를 명확히 전달하기 위해 enum 타입으로 전환되었습니다.
(2) enum sched_mode의 구성 (6.1 버전 기준)
__schedule()의 인자로 전달되는 모드는 보통 세 가지로 정의됩니다:
1) SM_NONE (구 false): 일반적인 스케줄링. 프로세스가 스스로 schedule()을 호출하여 CPU를 양보하거나, do_task_dead()처럼 종료 직전에 호출할 때 사용합니다.
2) SM_PREEMPT (구 true): 인터럽트나 타이머에 의해 현재 프로세스가 강제로 밀려날 때(선점) 사용합니다.
3) SM_WORK_WEEK (혹은 유사 명칭): 특정 작업(Worker) 스레드와 관련된 특수 모드입니다.
(3) do_task_dead()에서 SM_NONE을 쓰는 이유
질문하신 코드에서 __schedule(SM_NONE)을 호출하는 이유는 다음과 같습니다.
• 최후의 이별: do_task_dead()는 태스크가 죽기 직전 마지막으로 호출하는 함수입니다.
• 비선점의 의미: 누군가 나를 강제로 밀어낸 게 아니라, "나 이제 다 살았으니 스스로 CPU를 반납하고 다시는 돌아오지 않겠다"는 의지를 담아 호출하는 것이므로 SM_NONE 모드가 가장 적절합니다.
• 스케줄러의 처리: __schedule 내부에서는 SM_NONE인 경우, 현재 태스크의 상태(TASK_DEAD)를 확인하고 실행 큐(Runqueue)에서 이 녀석을 완전히 제거(Deactivate)합니다.
(4) 전문가를 위한 분석: finish_task_switch()와의 연결
주석에 적힌 final put_task_struct in finish_task_switch() 부분이 사실 가장 큰 팁입니다.
• 리눅스 커널은 "내가 나를 죽일 수 없다"는 원칙을 가집니다.
• do_task_dead()를 호출한 프로세스는 CPU를 떠나지만, 자신의 메모리(task_struct)를 직접 해제할 수 없습니다. (실행 중인 코드가 담긴 메모리를 날릴 순 없으니까요.)
• 그래서 __schedule을 통해 바통을 넘겨받은 "다음 프로세스(Next Task)"가 finish_task_switch() 단계에서 죽은 놈의 시체(task_struct)를 치워줍니다.
결론:
발견하신 이 변화는 "의미론적 프로그래밍(Semantic Programming)"으로의 진화입니다.
- 과거 (4.19 등): __schedule(false) → "음, 선점은 아니군." (추측 필요)
- 현재 (6.1): __schedule(SM_NONE) → "정상적인 절차에 따른 CPU 반납이군." (명확함)
6.1 버전을 보시면서 이런 변화를 짚어내시는 건, 최신 커널의 Type-Safe한 설계 철학을 정확히 관통하고 계신 겁니다.
1.4 do_task_dead() 함수를 호출하고 난 후의 동작
__schedule(false) 이후 끝일 것 같지만, 아직도 조금 남아 있습니다. 앞에서 말했던 자신의 프로세스가 해제 못하는 부분을 다음 프로세스에게 알려 해제하는 한다고 했습니다. 그렇게 하기 위한 작업이 남아 있습니다.
책에서 끔찍한 비유를 하지만, 간단하게, 자신의 스택 메모리 공간을 해제하고 소멸시켜 달라고 부탁하는 것이라고 마무리하고 있습니다. 마지막까지 따라가 봅니다.
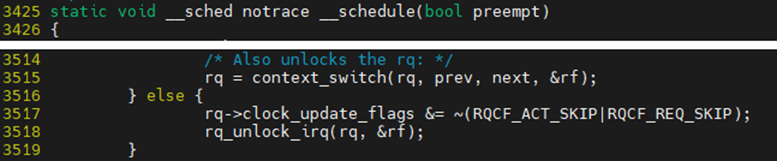
동일 파일(core.c)에 있는 __schedule() 함수를 확인합니다.
3515줄 : context_switch() 함수를 호출해 컨텍스트 스위칭을 실행합니다.
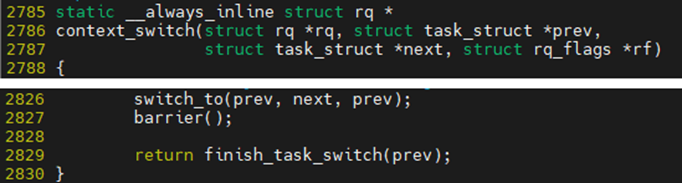
파일(core.c)에 있는 context_switch() 함수를 확인합니다. context_switch() 함수는 알아야 할 내용이 더 있으므로 '10장 스케줄러'에서 다시 한번 확인합니다.
2829줄 : finisih_task_switch() 함수를 호출합니다. schedule() 함수를 호출하면 결국 finisih_task_switch() 호출한다는 것을 알 수 있습니다.
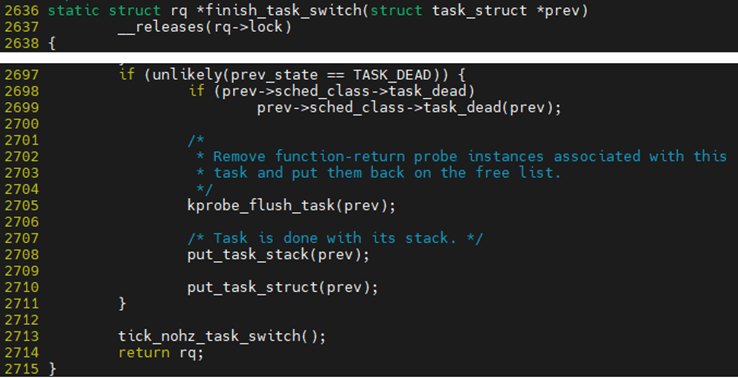
파일(core.c)에 있는 finisih_task_switch() 함수를 확인합니다.
2697~2710줄 : TASK_DEAD일 때 put_task_stack() 함수를 호출해서 프로세스의 스택 메모리 공간을 해제하고 put_task_struct() 함수를 호출해서 프로세스의 자료구조인 task_struct 위치의 메모리를 해제합니다.
finish_task_switch() 함수를 ftrace 필터 설정(set_ftrace_filter)에 걸고 한번 4_4_user_exit_process 프로그램을 다시 실행시켜 로그를 확인했습니다.
예전 글의 clone_process_debug_ftrace_setting.sh 내용에 추가했습니다.
4_4_user_exit_process의 종료 흐름이며 10124번째 줄에 pid-1231 프로세스에서 pid가 10인 rcu_sched프로세스로 스케줄링됩니다.
10125~10133번째 줄에서 rcu_sched 프로세스는 finish_task_switch() 함수에서 4_4_user_exit_process-1231 프로세스의 마지막 리소스를 정리합니다.
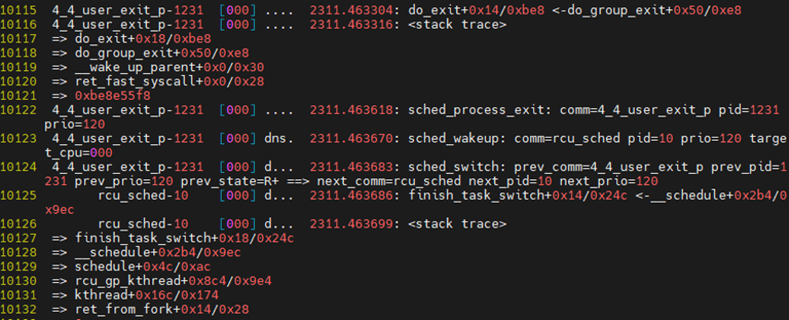
위에서 본 것처럼 4_4_user_exit_process-1231 프로세스는 do_exit() 함수에서 태스크 디스크립터와 여러 필드를 해제했습니다. 그러나 자신의 스택 공간에서 실행 중이니 스스로 자신의 스택공간을 해제할 수 없었기 때문에 스케줄링을 한 후 다음에 실행하는 프로세스인 rcu_sched가 종료되는 4_4_user_exit_process-1231 프로세스의 스택 메모리 공간을 해제합니다.
이것으로 프로세스의 생성과 종료 과정을 조금 깊게 확인해 보았습니다.
참고: https://remnant24c1.tistory.com/520#google_vignette
'Embedded : : Linux > : : Linux Kernel' 카테고리의 다른 글
| [프로세스] 태스크 디스크립터: task_struct 구조체 (0) | 2024.10.12 |
|---|---|
| 커널과 모듈의 개념 (0) | 2024.10.11 |
| [프로세스] 커널 내부 프로세스의 생성 과정 (0) | 2024.10.11 |
| [프로세스] 커널 쓰레드 (0) | 2024.10.10 |
| [프로세스] 프로세스 생성 (0) | 2024.10.10 |