1. 커널 스레드
앞서 유저 영역에서 실행한 프로세스가 어떤 과정으로 생성되고 종료되었는지 알아보았습니다.
이번에는 커널 공간에서만 실행되는 프로세스인 커널 스레드에 대해 알아보고 생성 과정을 살펴보도록 하죠.
1.1 커널 스레드
커널 프로세스는 커널 공간에서만 실행되는 프로세스이며, 대부분 커널 스레드 형태로 동작합니다.
리눅스 시스템 프로그래밍에서 데몬과 비슷한 일을 하는데, 데몬과 커널 스레드는 백그라운드 작업을 실행하면서 시스템 메모리, 전원 제어동작 수행합니다.
한편, 커널 스레드는 유저 영역과 시스템 콜을 받지 않고 동작한다는 점이 데몬과 다릅니다.
커널 스레드 특징
• 커널 공간에서만 실행, 유저 공간과 상호작용하지 않음
• 실행, 휴면 등 모든 동작을 커널에서 직접 제어 관리
• 대부분 커널 스레드는 시스템이 부팅할 때 생성되고, 시스템 종료 때까지 백그라운드로 실행
1.2 커널 스레드 종류
리눅스는 다양 배포판에서 구동되지만, 어떤 리눅스 시스템에서도 볼 수 있는 커널 스레드가 있습니다.
1.2.1 커널 스레드 항목 확인
ps 명령어로 현재 커널에서 동작하고 있는 커널 스레드를 확인하고 그중에 대표적인 커널 스레드 몇 개를 알아보겠습니다.
a: 터미널에 로그인한 모든 사용자의 프로세스를 표시합니다. 즉, 특정 사용자나 세션에 제한되지 않고 전체 시스템의 프로세스를 볼 수 있습니다.
x: 터미널에 연결되지 않은 백그라운드 프로세스도 포함하여 표시합니다.
j: 출력에 작업(job) 정보를 추가합니다. 이는 프로세스 그룹 ID, 세션 ID 등을 포함한 정보를 뜻합니다.
f: 포맷을 트리(tree) 형식으로 표시합니다. 부모 프로세스와 자식 프로세스 간의 관계를 계층적으로 보여줍니다.
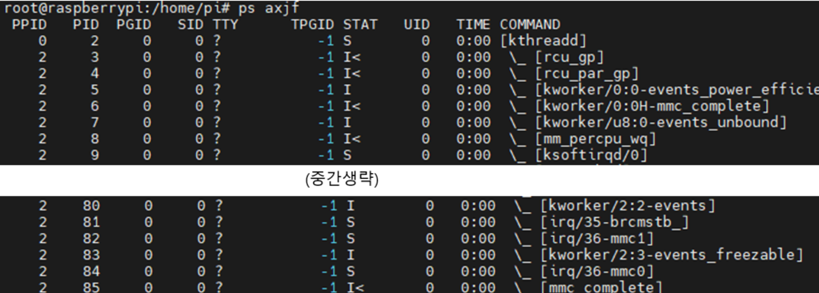
(1) kthreadd
kthreadd 프로세스는 모든 커널 스레드의 부로 프로세스입니다. 스레드 핸들러 함수는 kthreadd()이고 커널 스레드 생성을 담당합니다.
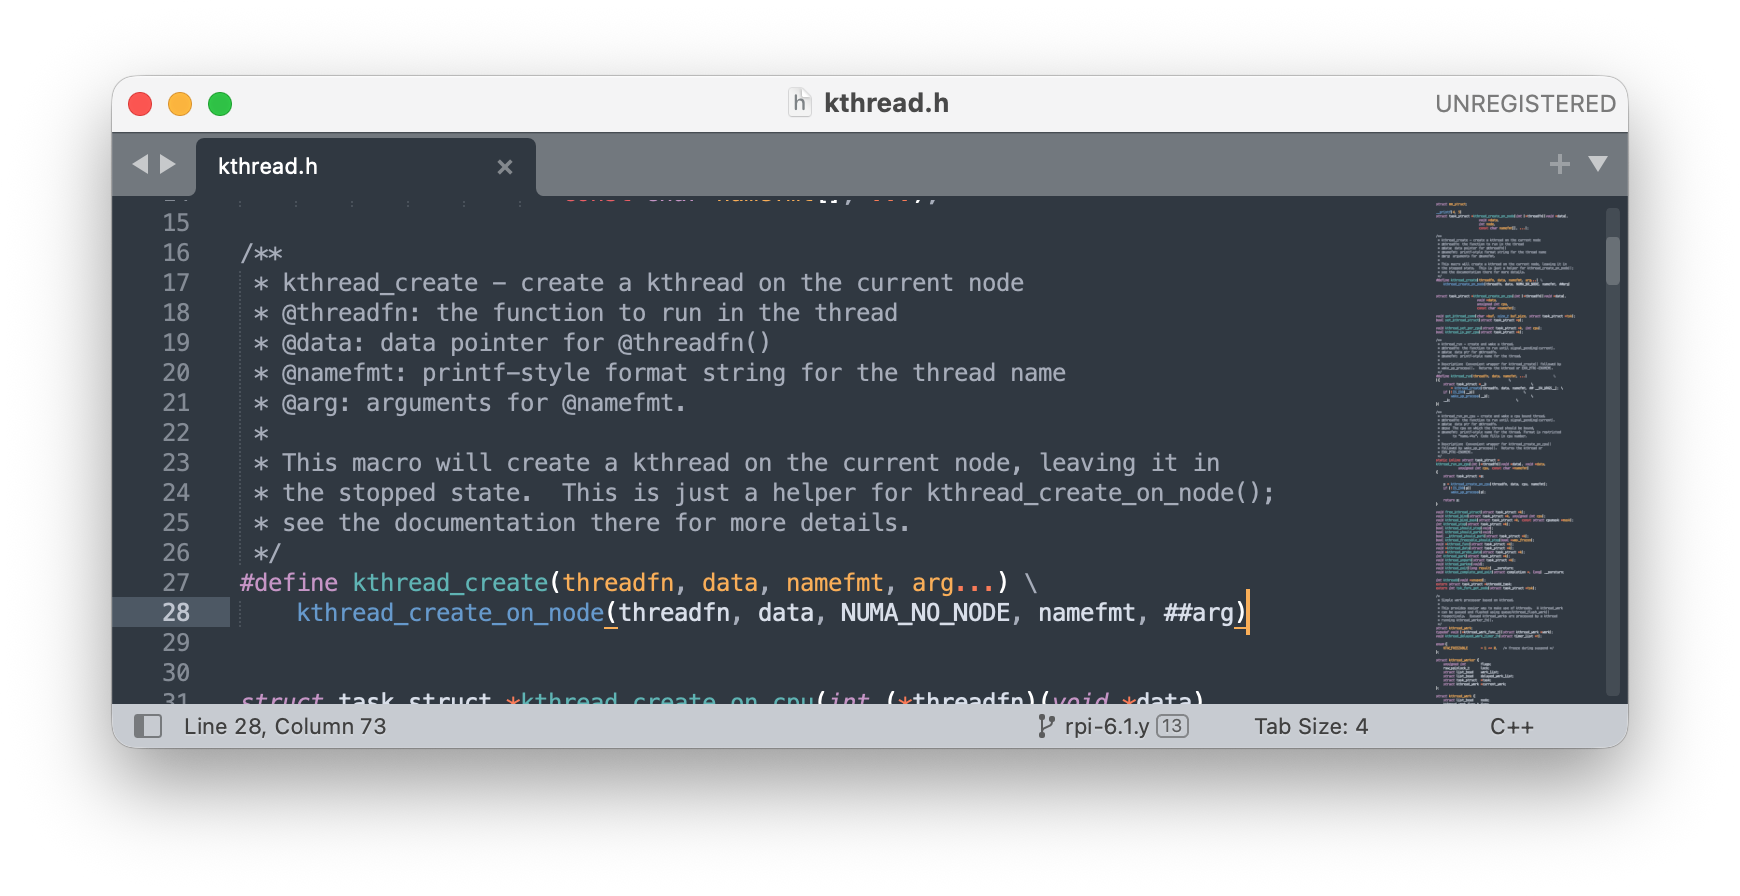
일반 프로세스와 달리, 프로세스가 실행하고 휴면 상태에 진입하는 동작을 커널 함수를 사용해서 구현해야 하고, 커널 스레드 생성 시 호출하는 kthread_create() 함수의 1번째 인자로 커널 스레드 핸들러 함수를 지정해야 합니다.
01 PPID PID PGID SID TTY TPGID STAT UID TIME COMMAND
02 0 2 0 0 ? -1 S 0 0:00 [kthreadd]
kthread_create() 함수의 선언부를 보면 커널 스레드 핸들러 함수를 지정하는 threadfn 인자를 볼 수 있습니다. 그렇기 때문에 커널 스레드 세부 동작은 핸들러 함수에 구현되어 있기 때문에 핸들러 함수 분석이 필요합니다.
(2) worker 스레드
워커 스레드는 워크큐에 큐잉된 Work를 실행하는 프로세스입니다.
(주 프로세스나 메인 스레드(Main Thread)가 차단(Block)되지 않도록, 시간이 오래 걸리거나 무거운 작업을 백그라운드에서 대신 처리하는 별도의 스레드)
01 PPID PID PGID SID TTY TPGID STAT UID TIME COMMAND
02 2 4 0 0 ? -1 I< 0 0:00 \_[kworker/0:0H]
워커 스레드란?
① 워커 스레드의 핵심 역할
일반적인 프로그램(특히 GUI나 웹 브라우저)은 하나의 메인 스레드에서 화면을 그리고 사용자의 클릭을 처리합니다. 만약 메인 스레드가 10GB짜리 파일을 다운로드하거나 복잡한 연산을 직접 수행하면, 그동안 화면은 '응답 없음' 상태가 되어 멈춰버립니다.
• 비차단(Non-blocking): 메인 스레드는 사용자 반응에 즉각 응답하고, 무거운 일은 워커 스레드에게 던져줍니다.
• 병렬 처리(Parallelism): 멀티코어 CPU 환경에서 여러 개의 워커 스레드를 돌리면 한 번에 여러 작업을 처리할 수 있어 효율이 급격히 올라갑니다.
② 워커 스레드의 동작 구조
• 작업 큐(Task Queue): 처리해야 할 일감들이 순서대로 쌓이는 곳입니다.
• 스레드 풀(Thread Pool): 워커 스레드를 매번 새로 만들고 버리는 것은 비용이 큽니다. 그래서 미리 일정 수의 워커 스레드를 만들어 두고(Pool), 작업이 들어올 때마다 하나씩 할당하여 재사용합니다.
• 결과 반환: 워커 스레드가 작업을 마치면 메인 스레드나 호출자에게 "완료되었습니다"라고 알리고 결과를 전달합니다.
③ 주요 활용 사례
• 모바일 앱/GUI: 네트워크 통신(API 호출), 이미지 디코딩, DB 쿼리 실행.
• 웹 개발 (Web Workers): 자바스크립트는 싱글 스레드지만, 브라우저의 Web Worker API를 사용하면 복잡한 연산을 백그라운드 스레드에서 수행할 수 있습니다.
• 서버 사이드: 수만 명의 접속자가 요청을 보낼 때, 각 요청을 워커 스레드가 나누어 처리하여 서버 전체가 멈추지 않게 합니다.
• 임베디드/커널: 인터럽트 처리 후 남은 무거운 작업들을 워커 스레드(Tasklet, Workqueue 등)로 넘겨 시스템의 실시간성을 유지합니다.
④ 주의할 점 (Trade-offs)
워커 스레드가 많다고 무조건 좋은 것은 아닙니다.
• 동기화 문제 (Race Condition): 여러 워커 스레드가 동시에 같은 메모리 공간에 접근하려 할 때 데이터가 꼬일 수 있습니다 (Mutex나 Semaphore가 필요한 이유).
• 컨텍스트 스위칭 비용: CPU가 처리하는 스레드를 바꿀 때 발생하는 비용이 커지면, 오히려 성능이 저하될 수 있습니다.
스레드 핸들러 함수는 worker_thread()이며, process_one_work() 함수를 호출해서 워크를 실행하는 기능을 수행합니다.
느린 작업을 백그라운드에서 실행하여 시스템 응답성을 높이며, workqueue에서 작업을 가져와 실행하며, 작업이 완료되면 Worker Thread는 새로운 작업을 기다리거나 대기 상태로 전환합니다.
리눅스에서 실행 중인 worker thread는 다음과 같은 패턴을 가집니다.
kworker/[CPU ID]:[worker ID]

<실행 흐름>
worker_thread() → run_workqueue() → process_one_work()
(메인 루프) → (작업 대기열 확인) → (작업 실행)
worker_thread()는 worker thread의 메인 루프이고 process_one_work()는 실제 작업을 실행하는 함수입니다. worker_thread()가 process_one_work()를 호출하는 구조가 됩니다. worker thread는 여러 작업을 연속적으로 처리하면서, workqueue 기반으로 동작합니다.
(3) ksoftirqd 스레드
ksoftirqd 스레드는 이름처럼 Soft IRQ를 위해 실행하는 프로세스입니다. 시스템의 응답성을 유지하면서도 CPU 부하가 큰 인터럽트 처리를 효율적으로 관리하기 위해 존재합니다.
Soft IRQ(소프트 인터럽트)는 하드웨어 인터럽트와 일반 프로세스 실행 사이에서 비동기적으로 실행되는 특별한 커널 작업입니다.
네트워크 패킷 수신, 타이머 이벤트, 블록 I/O 요청 처리 등의 작업을 담당하며 하드웨어 인터럽트 처리 후 긴 작업을 SoftIRQ로 넘겨서 실행 성능을 높입니다.
일반적으로 SoftIRQ는 인터럽트 컨텍스트에서 즉시 실행되지만, 만약 Soft IRQ가 너무 많아져서 CPU 사용량이 급증하면 리눅스 커널에서 ksoftirqd 스레드가 실행됩니다.
ksoftirqd 스레드는 smp_boot 형태의 스레드이며, 프로세스 이름의 맨 오른쪽에 실행중인 CPU 번호를 볼 수 있습니다.
간략하게 보자면 SoftIRQ 발생 → ksoftirqd 실행 과정은 아래와 같습니다.
(1) 하드웨어 인터럽트 발생, SoftIRQ가 등록됨
(2-1) SoftIRQ가 적으면 → 즉시 실행 (__do_softirq())
(2-2) SoftIRQ가 많아지면 → ksoftirqd가 실행됨 (run_ksoftirqd())
(3) run_ksoftirqd()가 대기 중인 SoftIRQ를 실행
(4) SoftIRQ 처리가 끝나면 → 다시 대기 상태 (schedule())
여기서 ksoftirqd 스레드의 핸들러는 run_ksoftirqd()이고 메인 루프 역할을 하는 함수입니다.
핵심 실행 흐름을 단계별로 설명해 드릴게요.
1) ksoftirqd의 탄생과 등록
커널이 초기화될 때 각 CPU마다 ksoftirqd 스레드를 생성합니다.
- spawn_ksoftirqd(): 시스템 부팅 시 호출되어 smp_hotplug_thread 구조체를 등록합니다.
- struct smp_hotplug_thread softirq_threads: 이 구조체 안에 스레드가 실행할 함수(thread_fn)로 run_ksoftirqd가 지정되어 있습니다.
2) 발생 및 대기 (The Trigger)
하드웨어 인터럽트 처리가 끝난 후, 커널은 do_softirq()를 호출하여 남은 소프트웨어 인터럽트(NET_RX, TASKLET 등)를 처리하려고 시도합니다. 하지만 다음 두 가지 상황이 발생하면 처리를 중단하고 ksoftirqd를 깨웁니다.
• 과도한 부하: 소프트웨어 인터럽트 처리 시간이 너무 길어져서 스케줄러가 "이대로는 다른 프로세스가 굶는다"라고 판단할 때.
• 재발생: 인터럽트를 처리하는 도중에 동일한 인터럽트가 다시 발생하여 루프가 끝나지 않을 때.
3) 스레드를 깨우는 조건: wakeup_softirqd()
하드웨어 인터럽트 핸들러(Top-half)가 끝나는 시점에 irq_exit()가 호출됩니다. 이때 소프트웨어 인터럽트(Bottom-half) 처리가 너무 오래 걸리면 wakeup_softirqd()를 통해 해당 CPU의 ksoftirqd를 깨웁니다.
커널은 각 CPU당 하나씩 할당된 ksoftirqd/n (n은 CPU 번호) 스레드를 깨웁니다. 이 스레드는 커널 우선순위가 낮게 설정되어 있어, 시스템에 급한 작업이 없을 때만 CPU 점유권을 가져옵니다.
• invoke_softirq(): irq_exit()에서 호출되어 __do_softirq()를 실행하려고 시도합니다.
• wakeup_softirqd(): 만약 __do_softirq()가 너무 많은 루프를 돌았거나 시간이 초과되면, 스케줄러에게 ksoftirqd를 실행해달라고 요청합니다.
4) 메인 루프(The Execution Loop) : run_ksoftirqd() 함수 실행 흐름
ksoftirqd는 kernel/softirq.c에 정의된 루프를 실행하며 대기 중인 소프트웨어 인터럽트를 처리합니다.
ksoftirqd 프로세스가 스케줄링되어 CPU를 점유하면, 실제 업무는 다음 함수 흐름을 따릅니다.
① 인터럽트 비활성화
현재 CPU의 로컬 인터럽트를 잠시 끕니다.
② run_ksoftirqd(unsigned int cpu):
스레드가 깨어나면 가장 먼저 실행되는 함수입니다.
③ local_softirq_pending():
현재 CPU에 처리해야 할(Pending 된) softirq가 있는지 비트마스크를 확인합니다.
④ __do_softirq() (핵심 함수):
Pending 된 인터럽트가 있다면 이 함수를 호출합니다. 이 안에서 실제 핸들러들이 실행됩니다.
h = softirq_vec; (등록된 핸들러 벡터 테이블을 가져옴)
h->action(h); (각 인터럽트에 매핑된 함수 실행, 예: 네트워크 패킷 처리를 위한 net_rx_action)
⑤ cond_resched():
__do_softirq() 내부의 루프가 한 번 끝나면, 다른 급한 프로세스가 있는지 스케줄링을 체크하여 CPU 점유를 잠시 양보합니다.
(이 과정 덕분에 ksoftirqd가 CPU를 100% 점유해도 시스템이 완전히 멈추지 않습니다.)
5) 다시 휴식 (Sleeping)
더 이상 처리할 소프트웨어 인터럽트가 없으면 ksoftirqd는 다시 TASK_INTERRUPTIBLE 상태(대기 상태)로 돌아가 커널의 호출을 기다립니다.
주요 특징 요약
• CPU 친화성 (Per-CPU): 각 CPU마다 독립적으로 존재하여 캐시 효율성을 높이고 락 경합을 줄입니다.
• 낮은 우선순위: 유저 프로세스의 실행을 방해하지 않도록 설계되었습니다. 만약 top 명령어로 확인했을 때 ksoftirqd의 CPU 점유율이 높다면, 현재 네트워크 트래픽이나 디스크 I/O가 시스템 감당 범위를 넘어서고 있다는 신호일 수 있습니다.
임베디드 환경에서 실시간성(Real-time)을 확보해야 하는 상황이라면, 이 ksoftirqd가 언제 깨어나는지를 제어하는 것이 성능 최적화의 핵심이 되기도 합니다.
(4) irq/86-mmc1 스레드
IRQ 스레드라고 하며, 인터럽트 후반부 처리를 위해 사용되는 프로세스입니다. 프로세스 이름으로 어떤 기능을 하는지 확인 가능해서, 확인하고자 한, irq/86-mmc1는 MMC/SD 카드 장치가 발생시키는 인터럽트(IRQ) 86번을 처리하는 커널 스레드라고 생각할 수 있습니다.
조금 더 내용을 설명하면,
SD 카드에서 데이터 읽기/쓰기 시 하드웨어 인터럽트(IRQ 86번)가 발생하면, 하드 IRQ 핸들러(Top Half)가 즉시 실행되어, 기본적인 인터럽트 처리를 수행합니다. 이후, 복잡한 처리가 필요하면 SoftIRQ 또는 irq/86-mmc1 같은 IRQ 스레드로 넘겨서 실행합니다. 결과적으로 MMC/SD 카드의 데이터 전송이 원활하게 이루어지도록 합니다.
1.3 커널 스레드 생성
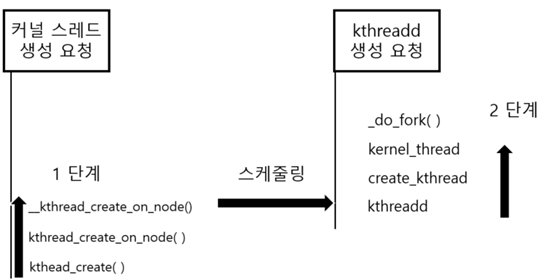
커널 스레드 생성하는 과정을 2단계로 확인합니다. 큰 흐름은 이전에 본 그림과 같습니다.
1.3.1 1단계 : kthreadd프로세스에게 커널 스레드 생성요청
커널 스레드를 생성하려면 kthread_create() 함수 호출해야 합니다.
(1) kthread_create() 함수 분석
함수 인자를 먼저 보면
int (*threadfn)(void *data)
스레드 핸들러 함수 주소를 저장하는 필드이고, 새로 생성될 스레드가 실행할(구현된) 함수입니다. 이 함수는 반환값이 0이면 성공적으로 종료됨을 의미합니다.
함수의 매개변수 data는 호출자가 전달하는 사용자 정의 데이터입니다.
void *data
threadfn(스레드 핸들러) 함수로 전달되는 매개변수입니다. 주로 주소를 전달하며, 스레드를 식별하는 구조체의 주소를 전달합니다. 사용자 정의 데이터를 포함할 수 있으며, 스레드 함수가 이 데이터를 활용하여 작업을 수행할 수 있습니다.
const char namefmt[]
새로 생성되는 커널 스레드의 이름을 지정합니다. 문자열 포맷 형식으로 사용할 수 있습니다. (예: "%s-thread")
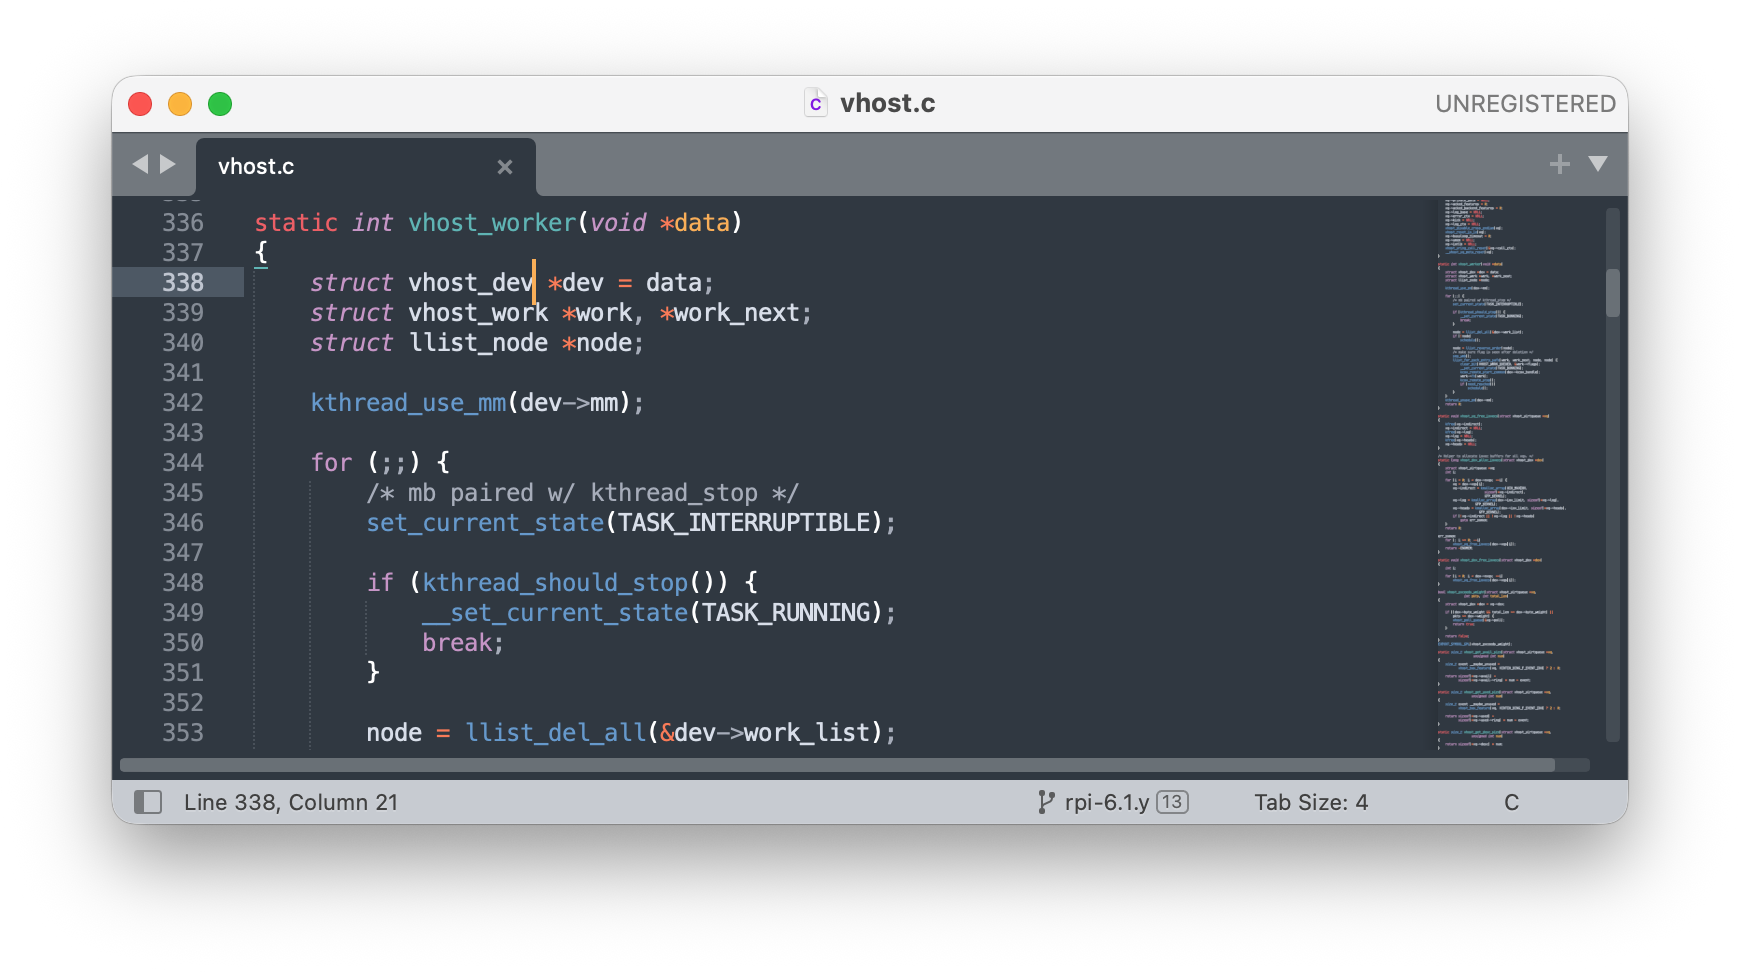
실제 kthread_create() 함수로 생성하는 코드를 확인합니다. 525번째 줄에 kthread_create() 함수 첫 번째 인자로 vhost_worker로 지정되어 있고, dev 변수는 아래의 vhost_worker 함수를 보면 알 수 있습니다.
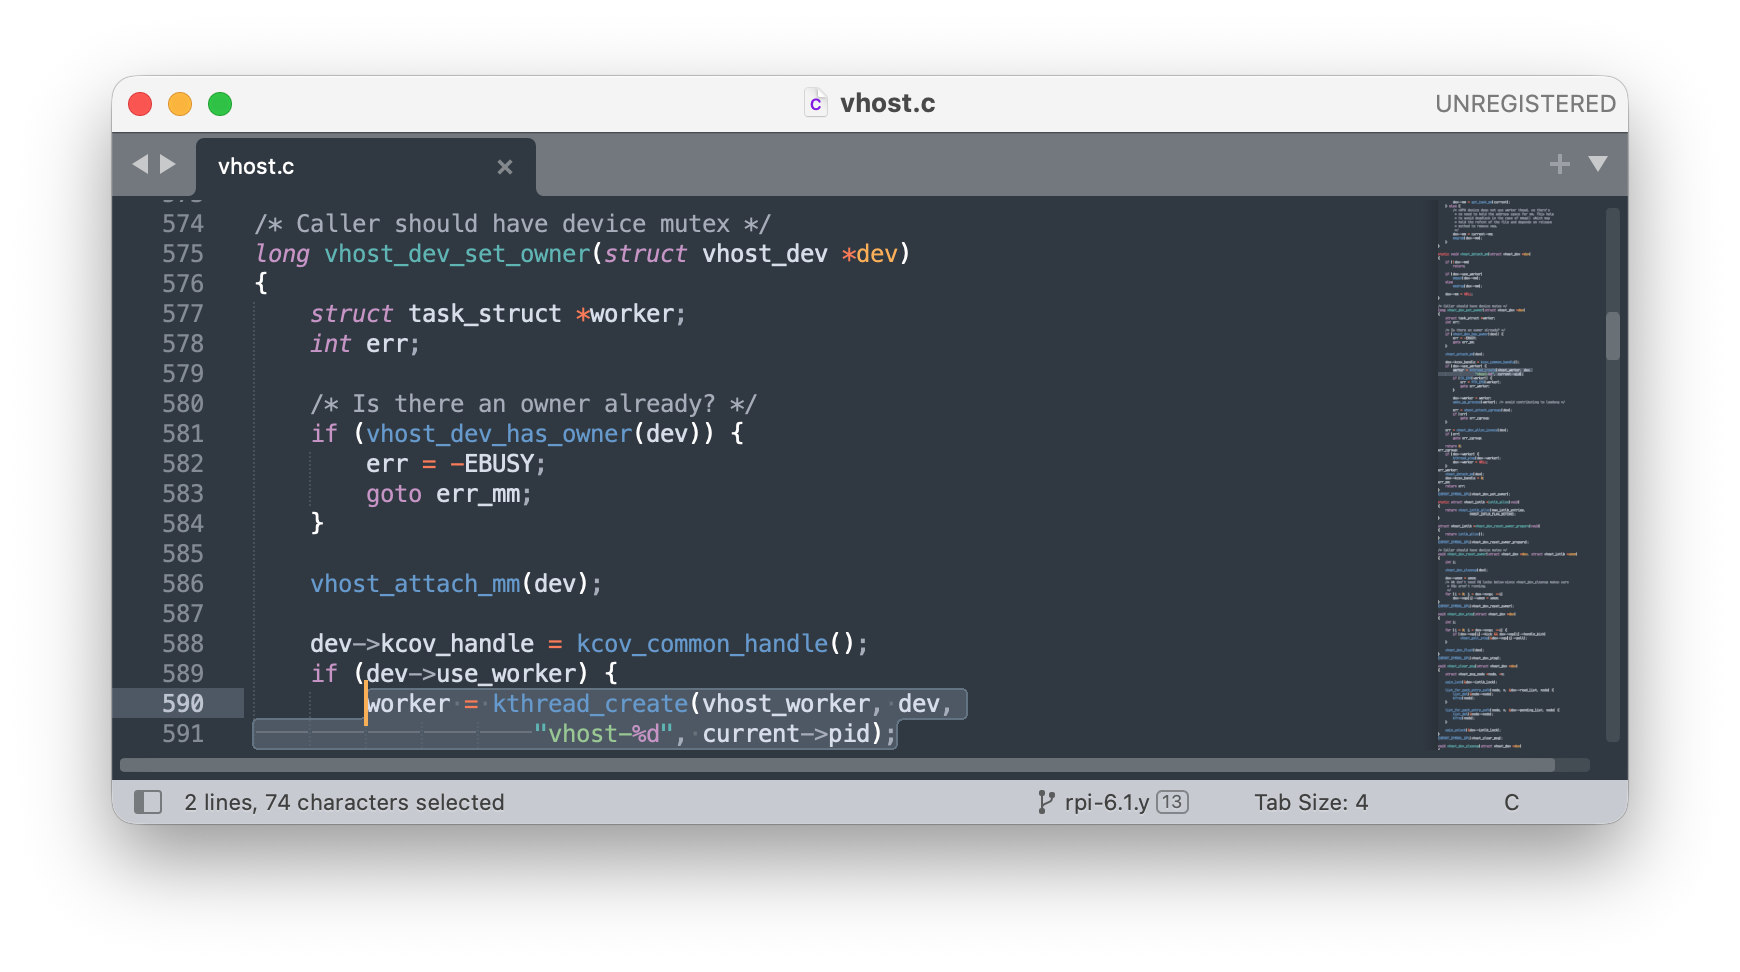
동일한 vhost.c 파일 내에 함수 내에 vhost_worker() 함수가 있으며, vhost_dev의 구조체의 주소를 kthread_create() 함수 2번째 인자로 전달했습니다.
338번째 줄을 보면 void 타입의 data 포인터를 vhost_dev구조체로 형변환해서 사용합니다. 커널에서 이 같은 방식으로 스레드를 관리하는 구조체를 매개변수(디스크립터)로 전달합니다.
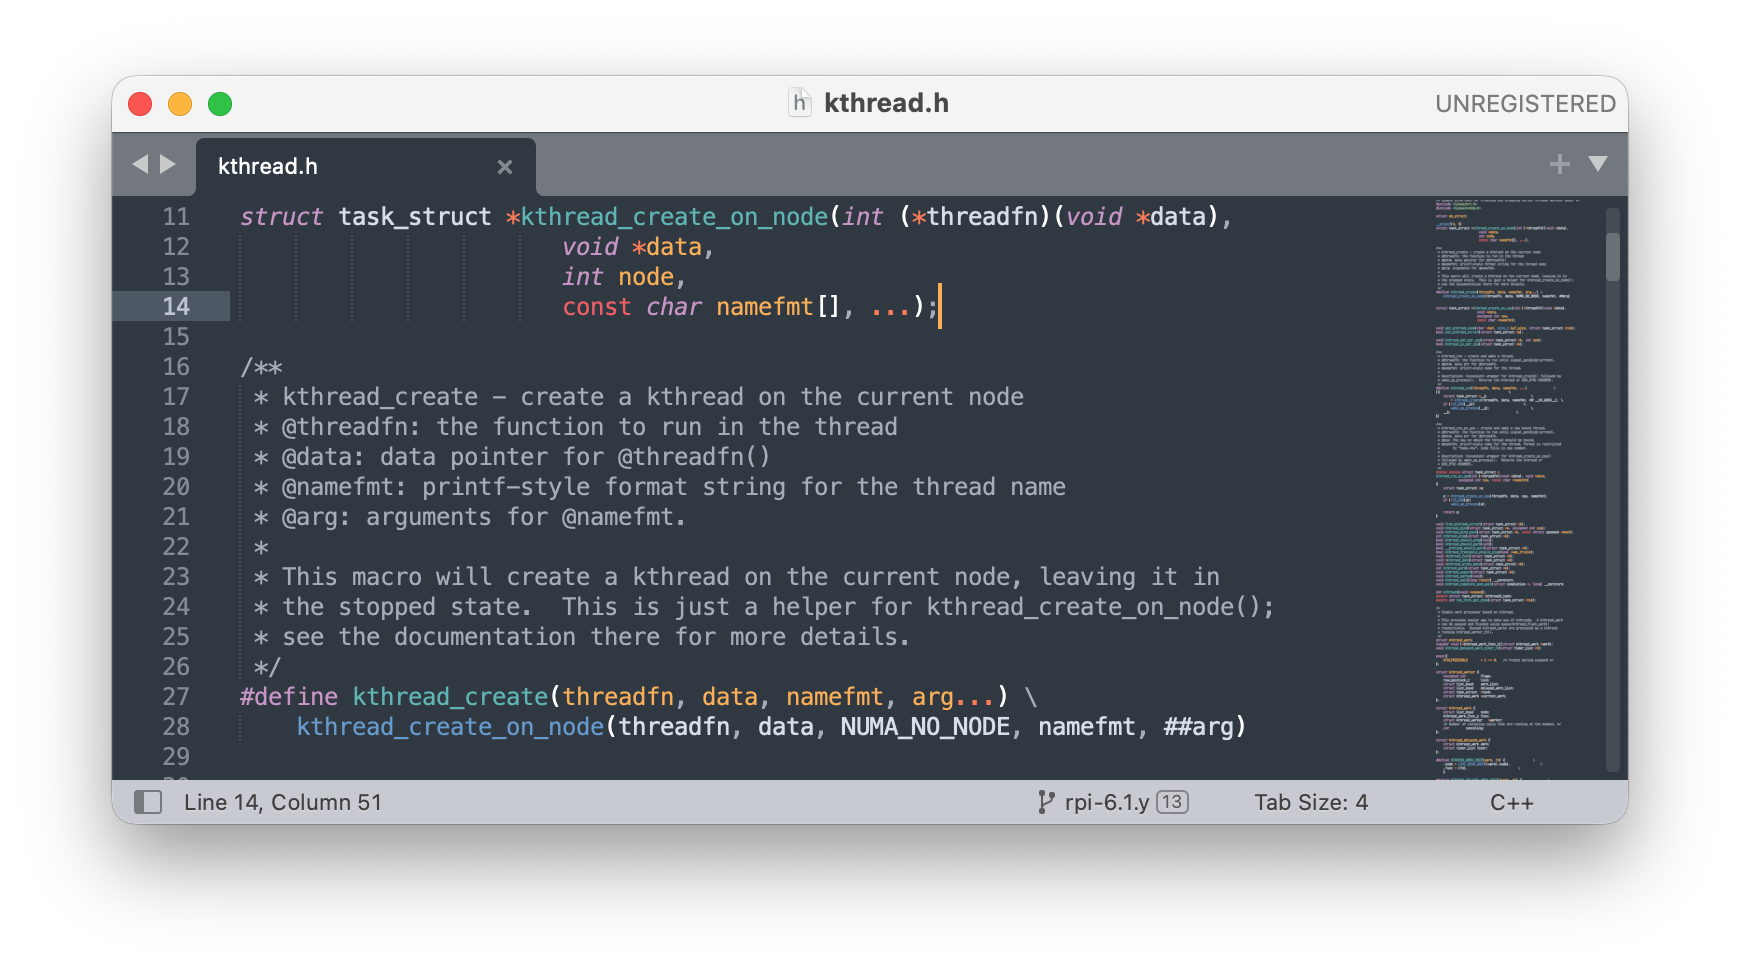
kthread_create() 함수는 선언부와 같이 매크로 타입으로 되어 있습니다.
그러나 커널 컴파일 과정에서 전처리기는 kthread_create_on_node() 함수로 바꿉니다.
즉, kthread_create() 함수를 커널이나 드라이버 코드에서 호출하면 kthread_create_on_node() 함수가 동작합니다.
그렇다면 kthread_create_on_node() 함수를 확인하는 것이 필요할 것입니다. kthread_create_on_node() 함수 내부를 따라가 보면 이 구조체가 어떻게 쓰이는지 명확히 보입니다.
그런데 구현부를 보면 특별한 코드가 있지 않고 가변인자를 통해 __kthread_create_on_node() 함수를 호출합니다.
- kthread_create_on_node 호출: 사용자가 스레드 생성을 요청합니다.
- 구조체 할당: 내부적으로 struct kthread_create_info *create를 동적 할당하여 정보를 채웁니다.
- 리스트에 추가: kthread_create_list라는 전역 리스트에 이 create 객체를 연결합니다.
- kthreadd 깨우기: wake_up_process(kthreadd_task);를 호출하여 2번 프로세스를 깨웁니다.
- 대기: wait_for_completion(&create.done);를 통해 스레드 생성이 완료될 때까지 호출 프로세스는 잠듭니다.
421번째 줄을 보면 kmalloc() 함수로 kthread_create_info 구조체만큼 동적메모리를 할당합니다. 296번~298번 줄은 커널 스래드 함수와 매개변수 및 노드를 생성한 구조체 필드에 저장합니다.
432번째 줄에서 커널 스레드 생성 요청을 관리하는 kthread_create_list 연결 리스트에 &create_list를 추가합니다.
kthreadd 프로세스는 kthread_create_list를 확인해서 커널 스레드 요청이 있었는지 확인하며, 비어 있지 않다면 커널 스레드를 생성을 시작합니다.
435번째 wake_up_process() 함수는 kthread 프로세스의 태스크 디스크립터(매개변수)인 kthread_task를 인자를 넣어 kthreadd프로세스를 깨웁니다.

grep -n "struct kthread_create {" kernel/kthread.c
일반적인 임베디드 환경에서는 node 값으로 NUMA_NO_NODE를 주로 사용하곤 합니다.
v6.1 커널 kthread 생성 상세 흐름 정리
1) 사용자 호출 (kthread.h)
kthread_create() 매크로 호출 → kthread_create_on_node() 호출.
2) 구조체 준비 및 요청 (kernel/kthread.c)
kthread_create_on_node()에서 threadfn, data, node 등을 채우고, 가변 인자(...)를 처리하기 위해 내부적으로 va_list를 준비.
실제 task는 __kthread_create_on_node()에서 실행.
작업 완료를 확인하기 위해 DECLARE_COMPLETION_ONSTACK(done)으로 동기화 객체를 준비합니다.
struct kthread_create_info *create = kmalloc(...)를 통해 요청 정보를 담을 메모리를 할당합니다.
3) 대기열 등록 및 깨우기
list_add_tail(&create->list, &kthread_create_list);를 통해 전역 요청 리스트에 넣습니다.
wake_up_process(kthreadd_task);를 호출하여 PID 2번(kthreadd)을 깨웁니다.
4) 동기화 대기
wait_for_completion_killable(&done)에서 호출자는 잠이 듭니다. kthreadd가 실제 스레드를 만들고 "다 만들었어!"라고 신호를 줄 때까지 기다리는 과정입니다.
5) kthreadd의 작업 (PID 2)
kthreadd는 리스트에서 create_info를 꺼내 kernel_thread()를 호출하여 실제 task_struct를 생성합니다.
생성이 끝나면 create->done에 complete()를 호출하여 기다리던 호출자를 깨웁니다.
한 가지 흥미로운 포인트
if (unlikely(wait_for_completion_killable(&done))) 부분은 상당히 정교한 예외 처리입니다. 만약 kthreadd가 메모리 할당 등을 하느라 바쁜 와중에, 호출 프로세스가 OOM Killer 등에 의해 죽게 될 경우를 대비해 xchg(&create->done, NULL)를 사용하여 중복 해제나 레이스 컨디션을 방지하는 로직이 들어가 있습니다.
1.2.2 2단계 : kthreadd가 커널 프로세스 생성
wake_up_process() 함수를 통해 kthreadd 프로세스가 깨어난 것을 확인했습니다. 깨어나면 kthreadd 프로세스의 스레드 핸들러인 kthreadd() 함수가 호출되어 프로세스를 생성합니다.
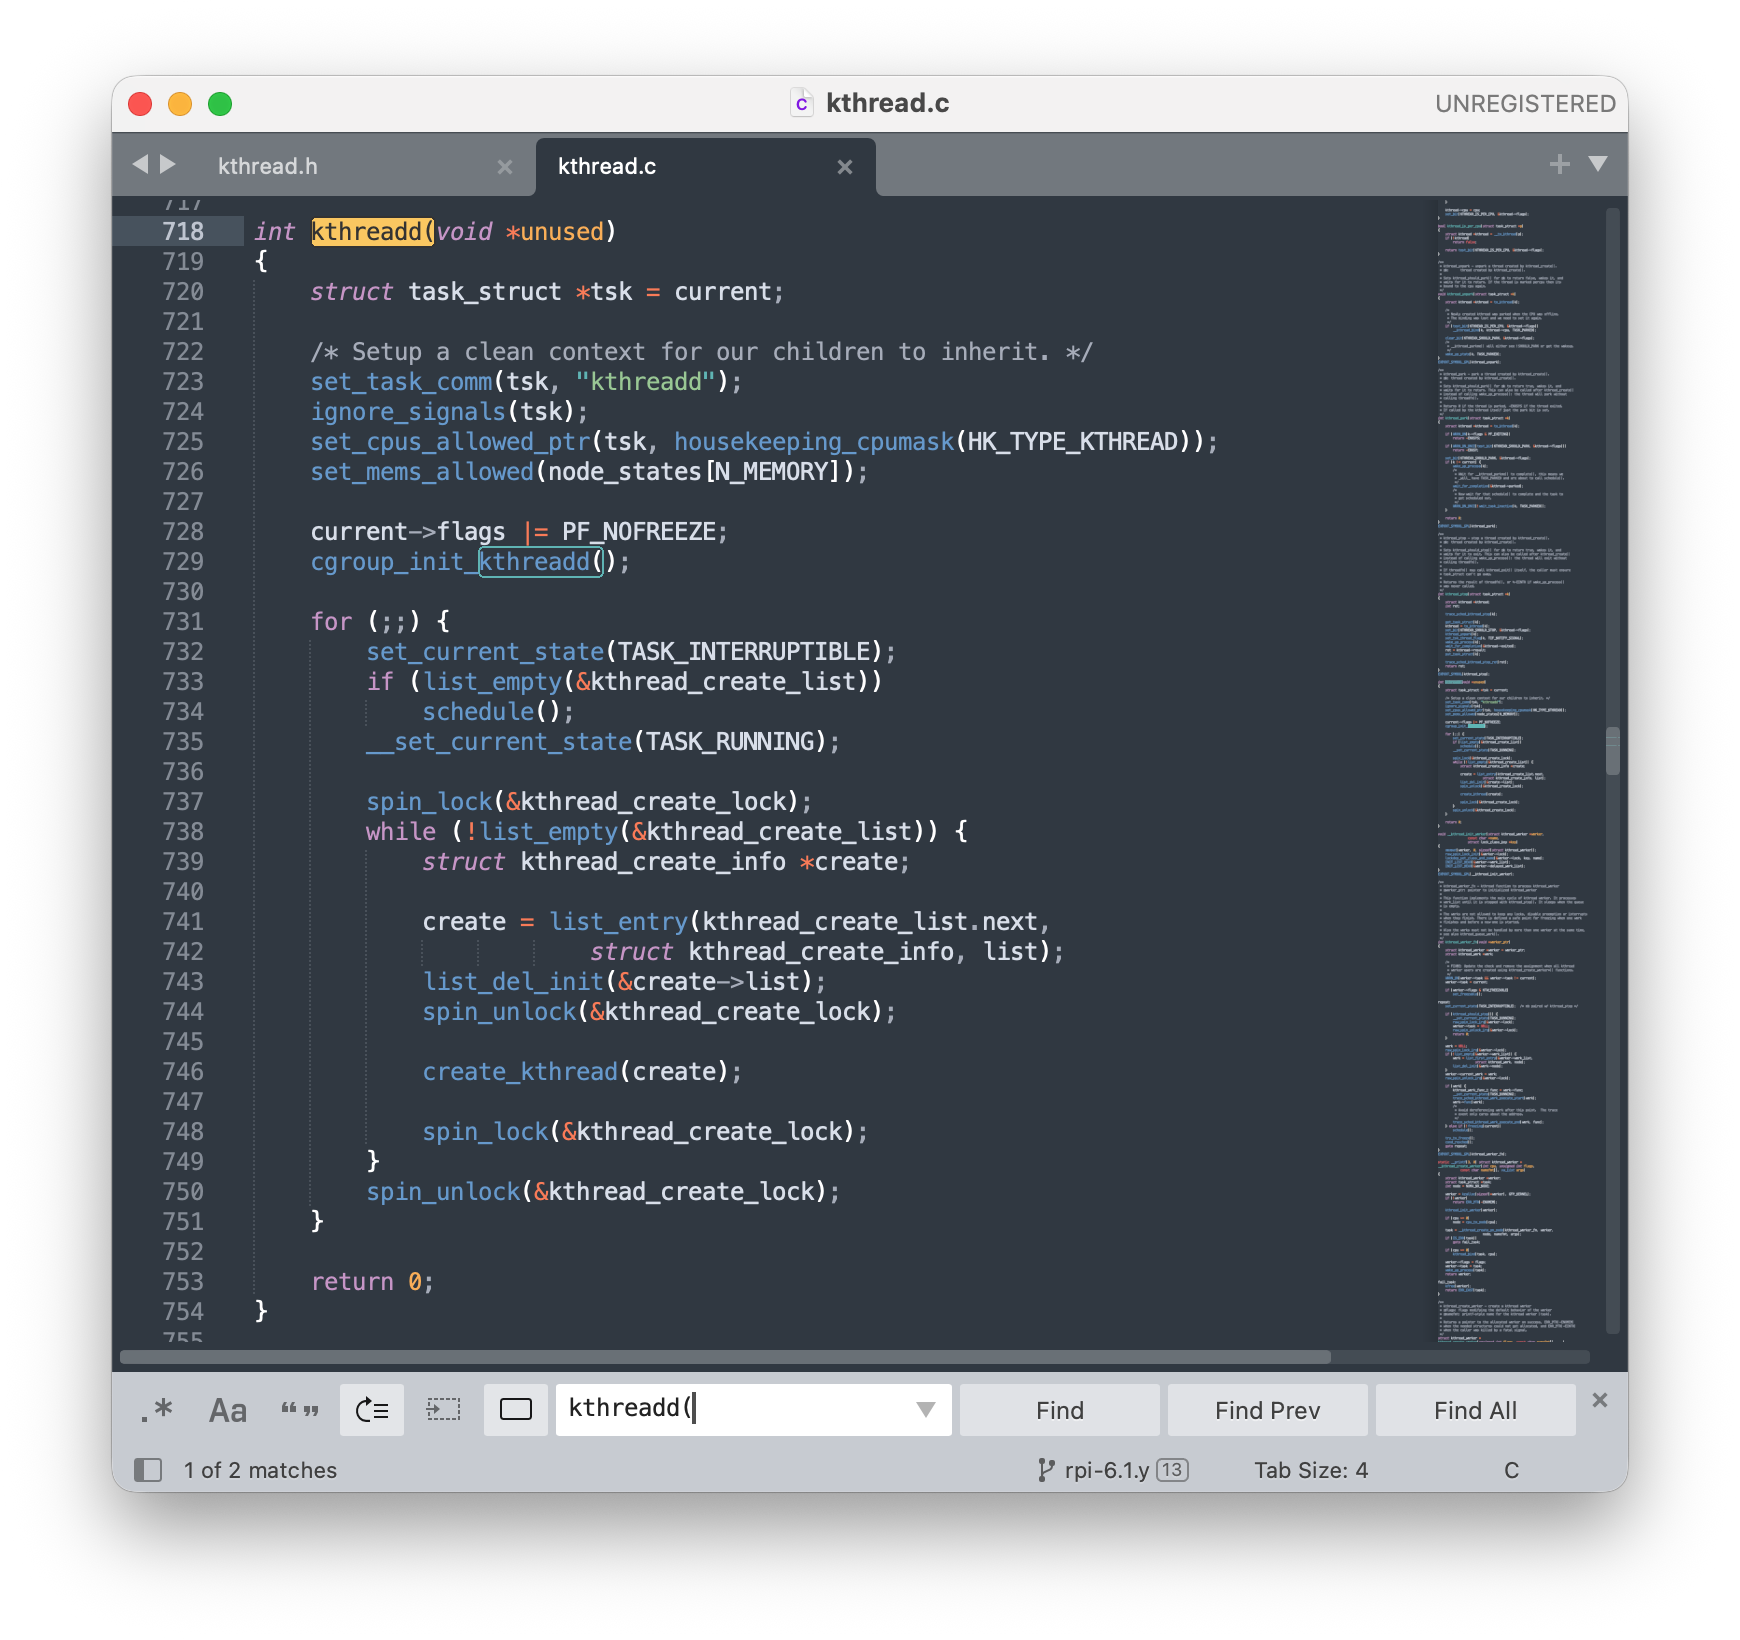
kthreadd() 함수에서 작동하는 코드를 확인해 보겠습니다. static int kthread() 함수도 같이 있기 때문에 한번 더 함수 이름 확인 후에 코드를 보시기 바랍니다.
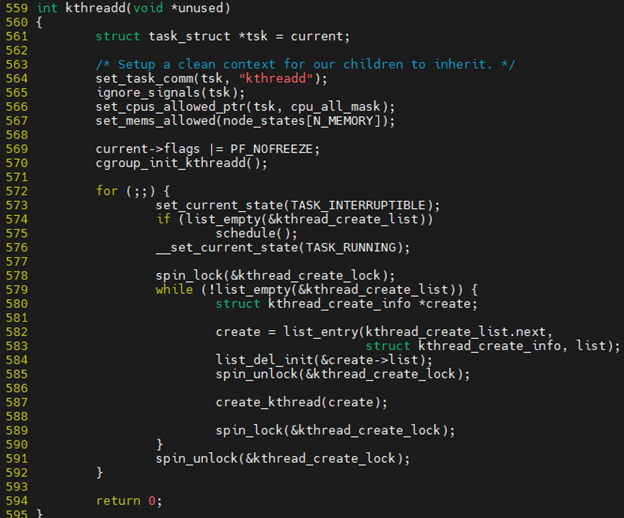
for(;;) 문이기 때문에 무한 루프를 돌게 되는데, 책에서 kthreadd 프로세스를 깨우면 함수 어느 부분에서 실행하게 되는지와 생성할 프로세스가 없을 때 어느 코드가 실행할까요?라고 질문하고 있습니다.
책 내용을 보면 알겠지만, 574, 575번째 줄을 보면 리스트가 없으면 휴면상태로 들어가게 되고, 깨우면 576줄이 실행되는데, 이는 휴면상태 후 바로 다음 코드이기 때문입니다.
579번째 줄은 kthread_create_list 연결 리스트가 비어 있지 않을 조건을 확인하고 580~589번째 줄까지 해서 커널 스레드를 생성합니다.
kthreadd() 함수 핵심 기능은 kthread_create_info 연결 리스트를 확인해서 프로세스 생성 요청을 확인하고, create_kthread() 함수를 호출해 프로세스를 생성하는 것입니다.
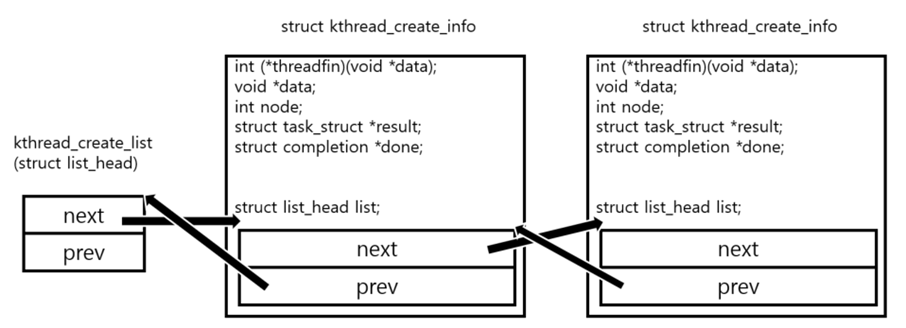
582,583번째 줄을 보면 kthread_create_list.next 필드를 통해 kthread_create_info 구조체의 주소를 읽습니다.
kthread_create_info 구조체 내용을 먼저 확인합니다. 구조체 마지막 필드는 list이며 struct list_head 타입입니다.
아래 kthread_create_info 구조체 관계에서 보면, kthread_create_list 전역변수의 next 필드가 kthread_create_info 구조체의 list 필드 주소를 가리키고 있습니다.
이렇게 하면 kthread_create_info 구조체에서 list 필드의 오프셋을 계산해 kthread_create_info 구조체의 시작 주소를 알 수 있습니다.
(왜 이렇게 작업하는 걸까 궁금해서 마지막(참고 TIP)에 조금 더 내용을 추가해 보았습니다.)
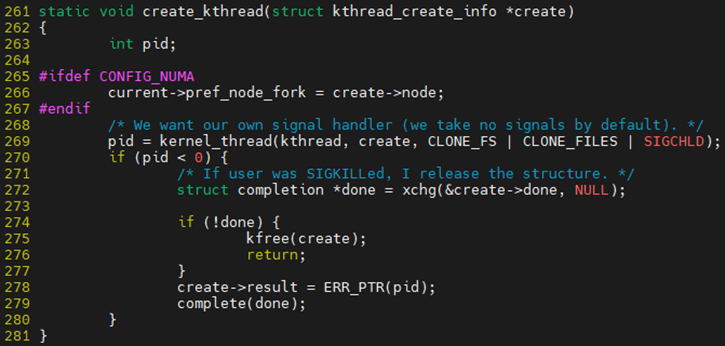
587번째 줄에서 create_kthread() 함수를 호출해서 커널 스레드를 생성합니다.
그러면 create_kthread() 함수를 확인합니다. 함수는 kthread.c 동일 파일에 구현되어 있습니다.
269번째 줄에 CLONE_FS | CLONE_FILES | SIGCHLD 매크로를 추가해서 kernel_thread() 함수를 호출합니다.
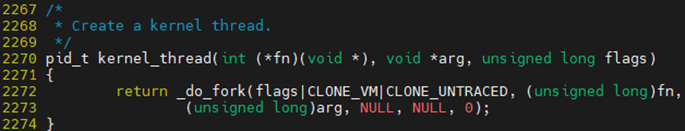
호출한 kernel_thread() 함수를 확인해 봅니다. kernel_create() 함수는 fork.c 파일에 구현되어 있습니다.
최종적으로 _do_fork() 함수를 호출해서 프로세스를 생성합니다. 위에서 thread로 따라왔지만, 최종적으로 커널 스레드도 프로세스의 한 종류인 것을 알 수 있습니다.
함수를 따라가는 것이 쉽지는 않은 듯합니다. 정리한다면 처음에 봤던 그림이 되지 않을까 합니다. 내부적으로 어떻게 구성이 이렇게 이어져 커널 스레드가 만들어지는구나 알 수 있는 시간이었습니다.

참고 TIP)
kthread_create_list 전역변수의 next 필드가 kthread_create_info 구조체의 list 필드 주소를 가리키고 있을까 의문이 들었습니다. 기본 자료구조를 배웠다면 kthread_create_info 구조체 주소를 넣어서 Double Linked List를 만들면 되는 것 아닌가 생각할 수 있을 것입니다. (아직 리눅스 커널에 대한 초보라...)
이는 리눅스 커널에서 흔히 사용하는 container_of 패턴 때문이라고 합니다. 리눅스 커널에서는 일반적으로 구조체의 일부 필드(예: list 필드)의 주소를 링크드 리스트에 저장하고, 이를 통해 전체 구조체의 시작 주소를 얻는 방식을 사용합니다.
리눅스 커널에서 container_of 매크로를 이용하면, 특정 필드의 주소를 가지고 해당 필드가 포함된 전체 구조체의 시작 주소를 계산할 수가 있다고 합니다. 이 매크로는 ptr이 구조체 type 내의 member 필드 주소일 때, type 구조체의 시작 주소를 반환합니다.
#define container_of(ptr, type, member) \
(type *)((char *)(ptr) - (unsigned long)(&((type *)0)->member))
이해가 되지 않아서, GPT의 도움을 받아 사용 예제를 확인해 보았습니다.
#include <stdio.h>

#define container_of(ptr, type, member) \
    (type *)((char *)(ptr) - (unsigned long)(&((type *)0)->member))

// 예제 구조체 정의
struct my_struct {
    int a;
    double b;
    char c;
};

int main() {
    struct my_struct obj = {10, 3.14, 'X'};

    // 멤버 `b`의 주소를 가져옴
    double *b_ptr = &obj.b;

    // `b_ptr`을 사용하여 `obj`의 전체 구조체 주소를 얻음
    struct my_struct *struct_ptr = container_of(b_ptr, struct my_struct, b);

    // 원래 구조체의 주소와 비교
    printf("Original struct address: %p\n", (void *)&obj);
    printf("Retrieved struct address: %p\n", (void *)struct_ptr);

    return 0;
}
그렇다면 왜 이렇게 설계했을까?입니다.
(1) 일반적인 list_head 기반 링크드 리스트를 사용할 수 있음
리눅스 커널에서는 list_head를 이용한 링크드 리스트가 많고 모두 동일한 방식으로 관리할 수 있도록 일관된 설계를 유지하기 위해서입니다.
struct task_struct
struct file_operations
struct inode
struct kthread_create_info
(2) container_of를 이용한 유연성
구조체 내부의 특정 필드를 이용해 전체 구조체의 주소를 얻을 수 있기 때문에
필드 위치가 바뀌어도 코드 수정이 최소화합니다.
(3) 확장성
만약 kthread_create_info의 구조가 바뀌어도 list_head를 유지하면 링크드 리스트 구조는 그대로 유지 가능 합니다. 즉, 다른 리스트 구조체와 호환이 쉬워집니다.
감사합니다.
참고: https://remnant24c1.tistory.com/514
'Embedded : : Linux > : : Linux Kernel' 카테고리의 다른 글
| [프로세스] 프로세스의 종료 과정 분석 (0) | 2024.10.11 |
|---|---|
| [프로세스] 커널 내부 프로세스의 생성 과정 (0) | 2024.10.11 |
| [프로세스] 프로세스 생성 (0) | 2024.10.10 |
| [프로세스] 프로세스 확인하기 (0) | 2024.10.10 |
| 커널 디버깅용 debugfs 드라이버 코드 (0) | 2024.10.10 |