1. 커널 내부 프로세스의 생성 과정
커널 프로세스의 생성과정을 살펴봅시다.
커널 프로세스는 커널 함수를 써서 프로세스를 생성합니다. kthread() 함수를 호출해 커널 프로세스 생성을 전담하는 kthreadd 스레드에게 프로세스 생성을 요청합니다.
유저와 커널 두 종류의 프로세스를 생성할 때 공통적으로 실행되는 kernel_clone() 함수를 분석하면서 커널에서 프로세스를 생성하는 과정을 살펴보겠습니다.
1.1 kernel_clone() 함수
kernel_clone() 함수의 동작은 크게 2단계로 분류할 수 있습니다.
1단계: 프로세스 생성
copy process() 함수를 호출하여 프로세스를 생성하며, 이름처럼 부모 프로세스의 리소스를 자식 프로세스에게 복제합니다.
2단계: 생성한 프로세스의 실행 요청
copy_process() 함수를 호출해 프로세스를 만든 후 wake_up_new_task() 함수를 호출해서 프로세스를 깨웁니다(스케줄러에 실행요청).
kernel/forc.c
copy_process() 함수를 호출해 부모 프로세스의 메모리 및 시스템 정보를 자식 프로세스에게 복사합니다.
p라는 포인터형 변수에 오류가 있는지 검사합니다. 만약 태스크 디스크립터의 주소를 담고 있는 p 포인터 변수에 오류가 있으면 오류코드를 반환하면서 함수의 실행을 종료합니다. 오류가 없으면 아래의 코드가 실행됩니다.
trace_sched_process_fork(current, p); 는 ftrace 이벤트 중 sched_process_fork를 활성화 했을 때 동작합니다. '프로세스 생성' 동작을 나타내는 sched_process_fork 이벤트에 대한 메시지는 다음과 같습니다.
이 메시지를 보고 "pid가 2인 kthreadd 프로세스가 pid가 17193인 프로세스를 생성한다"로 해석할 수 있습니다.
여기서는 pid를 계산해 nr 지역변수에 저장합니다. 정수형 타입인 nr 변수는 프로세스의 pid이며 kernel_clone() 함수가 실행을 종료한 후 반환합니다.
생성한 프로세스를 깨우는 동작입니다.
프로세스의 pid를 담고있는 정수형 타입의 nr 지역변수를 반환합니다. 프로세스의 PID를 반환하는 동작입니다.
• copy_process() 함수를 호출해 프로세스를 생성
• wake_up_new_task() 함수를 호출해 생성한 프로세스를 깨움
• 생성한 프로세스 PID를 반환
1.2 copy_process() 함수 분석
프로세스를 생성하는 핵심 동작은 copy_process() 함수에서 수행합니다. 대부분 부모 프로세스에 있는 리소스를 복사하는 동작입니다.
/kernel/fork.c
dup_task_struct() 함수는 생성할 프로세스의 태스크 디스크립터인 task_struct 구조체와 프로세스가 실행될 스택 공간을 할당합니다. 이후 task_struct 구조체 주소를 반환합니다. dup_task_struct() 함수를 호출해 태스크 디스크립터를 p에 저장합니다.
태스크 디스크립터를 나타내는 tast_struct 구조체에서 스케줄링 관련 정보를 초기화합니다.
프로세스의 파일 디스크립터 관련 내용(파일 디스크립터, 파일 디스크립터 테이블)을 초기화합니다.
부모 file_struct 구조체의 내용을 자식 프로세스에게 복사합니다.
만약 프로세스 생성 플래그중 CLONE_FILES로 프로세스를 생성했을 경우 참조 카운트만 증가합니다.
프로세스가 등록한 시그널 핸들러 정보인 sighand_struct 구조체를 생성해서 복사합니다.
이상 copy_process() 함수를 실행해 부모 프로세스의 task_struct 구조체에 복제하는 과정을 살펴보았습니다.
이어서 생성한 프로세스를 바로 실행해야 합니다.
1.3 wake_up_new_task() 함수 분석
프로세스 생성의 마지막 단계로, 생성한 프로세스를 깨웁니다. 이는 wake_up_new_task() 함수가 수행합니다.
• 프로세스 상태를 TASK_RUNNING으로 변경
• 현재 실행중인 CPU 번호를 thread_info 구조체의 cpu 필드에 저장
• 런큐에 프로세스를 큐잉
linux/kernel/sched/core.c
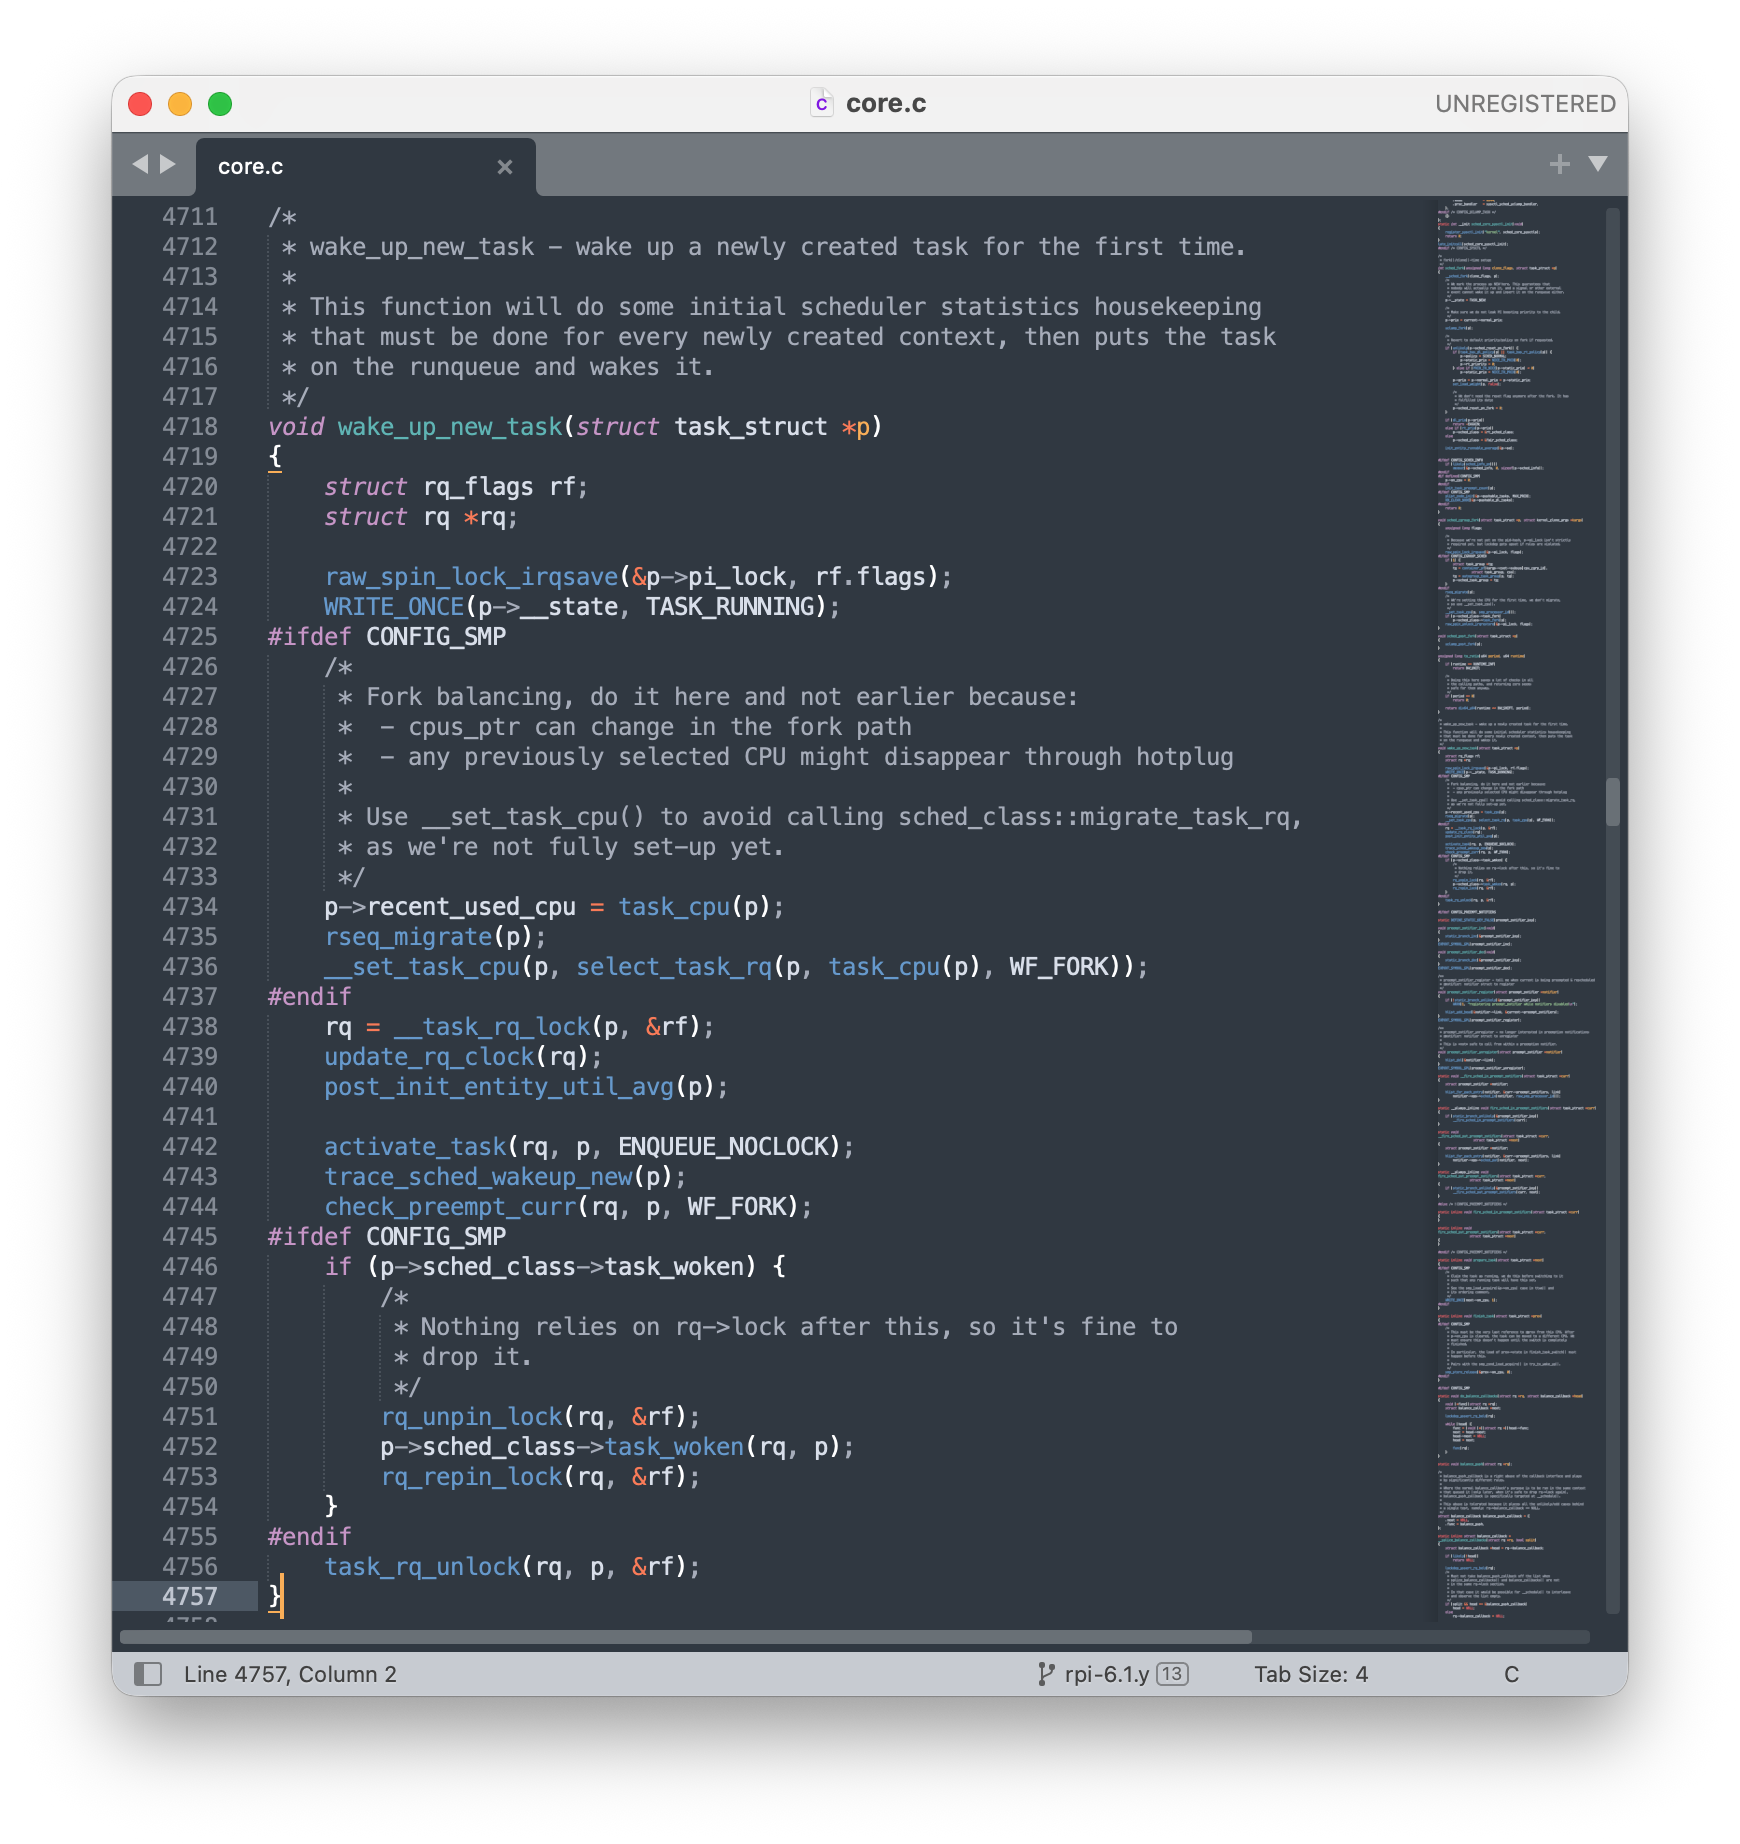
새로 생성된 프로세스(p)의 상태를 '실행 가능 상태(TASK_RUNNING)'로 공식적으로 전환하는 지점입니다.
리팩토링 배경: 왜 p->state = TASK_RUNNING; 같은 단순 대입문이 아닌 WRITE_ONCE와 __state 사용하는가?
(1) 왜 state가 아니라 __state인가요? (리팩토링)
과거 커널에서는 task_struct 내의 상태 변수 이름이 그냥 state였습니다. 하지만 v5.14~v5.15 부근에서 대대적인 리팩토링이 진행되었습니다.
• 배경: 프로세스의 상태(state)는 여러 CPU가 동시에 접근하거나, 스케줄러가 매우 민감하게 체크해야 하는 값입니다. 개발자들이 실수로 이 값을 직접 건드려 레이스 컨디션(Race Condition)이 발생하는 것을 막기 위해 이름을 __state로 바꾸고 "직접 접근하지 말 것"을 암시하게 되었습니다.
• 컴파일러 최적화 방지: __state로 변경되면서 이 값을 읽거나 쓸 때는 반드시 커널이 제공하는 래퍼 함수나 매크로를 통하도록 권장하고 있습니다.
(2) WRITE_ONCE를 사용하는 이유
단순히 p->__state = TASK_RUNNING;이라고 써도 동작은 하겠지만, 커널은 훨씬 엄격합니다.
• 원자성 및 최적화 금지: WRITE_ONCE 매크로는 컴파일러가 이 쓰기 작업을 마음대로 순서를 바꾸거나(Reordering), "어차피 나중에 또 쓰니까 이번엔 생략하자"라고 최적화하는 것을 방지합니다.
• 메모리 가시성: 멀티코어 환경에서 다른 CPU가 p->__state를 읽었을 때, 방금 업데이트된 TASK_RUNNING 상태를 즉시, 그리고 정확하게 볼 수 있도록 보장하기 위해 사용합니다.
(3) wake_up_new_task에서의 의미
copy_process()가 막 끝난 직후의 프로세스는 아직 '태어났지만 움직이지는 못하는' 상태입니다. wake_up_new_task()함수는 이 아기 프로세스를 세상(Runqueue)에 내놓는 역할을 합니다.
• p->pi_lock 획득: 프로세스의 우선순위와 상태를 보호하기 위해 락을 잡습니다.
• 상태 변경: WRITE_ONCE(p->__state, TASK_RUNNING)을 통해 이제 이 프로세스는 스케줄러에 의해 CPU를 할당받을 자격을 갖추게 됩니다.
• Runqueue 진입: 이후 코드에서 activate_task(rq, p, ...) 등을 호출하여 실제 CPU의 실행 대기열(Runqueue)에 이 프로세스를 집어넣습니다.
요약하자면
- 리팩토링 맞습니다: 직접적인 state 접근을 막고 가시성을 확보하기 위해 __state와 WRITE_ONCE 조합으로 바뀌었습니다.
- 상태 전환: 이 줄을 실행하기 전까지는 그냥 메모리 덩어리였던 task_struct가, 이 줄을 기점으로 실행 대기 중인 실제 프로세스로 승격되는 아주 중요한 순간입니다.
드라이버나 실시간 오디오 처리를 하실 때, 특정 스레드가 왜 스케줄링되지 않는지 디버깅하려면 이 __state가 어느 시점에 TASK_RUNNING으로 바뀌는지(혹은 왜 TASK_INTERRUPTIBLE에 머물러 있는지) 확인하는 것이 핵심이 됩니다. 직접 코드를 분석하시니 커널의 동기화 메커니즘이 확 와닿으시죠?
* - 포크 경로에서 cpus_ptr이 변경될 수 있습니다.
* - 핫플러그로 인해 이전에 선택된 CPU가 사라질 수 있습니다.
*
* 아직 완전히 설정되지 않았으므로 sched_class::migrate_task_rq 호출을 피하기 위해 __set_task_cpu()를 사용하십시오.
#ifdef CONFIG_SMP
kernel/sched/core.c (혹은 wake_up_new_task 주변)의 핵심부를 찌르셨네요! 이 코드는 멀티코어 환경에서 "새로 태어난 프로세스를 어느 CPU(코어)에 배정할 것인가"를 결정하는 매우 중요한 대목입니다.
구조적으로 하나씩 풀어서 설명해 드릴게요.
(1) CONFIG_SMP란 무엇인가?
SMP는 Symmetric Multi-Processing의 약자로, 쉽게 말해 "코어가 2개 이상인 멀티코어 환경"을 의미합니다.
• 의미: 커널을 빌드할 때 설정하는 옵션입니다. 요즘 스마트폰(삼성 MX)이나 자동차용 AP(현대차 i.MX8M Plus)는 모두 멀티코어이므로 이 옵션은 항상 y(활성화) 상태입니다.
• 왜 #ifdef를 쓰나: 코어가 1개뿐인 환경(싱글 코어)에서는 "어느 CPU에 보낼지" 고민할 필요가 없겠죠? 그래서 멀티코어일 때만 동작하도록 코드를 격리해둔 것입니다.
(2) 코드 라인별 상세 분석
이 부분은 부모 CPU에서 자식 CPU로의 이사(Load Balancing)를 준비하는 과정입니다.
① p->recent_used_cpu = task_cpu(p);
• 내용: 자식 프로세스(p)가 현재 임시로 배정된 CPU 번호를 '최근 사용 기록'에 저장합니다.
• 이유: 나중에 스케줄러가 이 프로세스를 어디로 보낼지 결정할 때, "방금까지 어디 있었지?"라는 정보(Affinity/Cache Hot)를 참고하기 위해서입니다.
② rseq_migrate(p);
• 내용: Restartable Sequences(rseq) 기능을 위한 마이그레이션 처리입니다.
• 이유: 유저 공간에서 CPU 전용 데이터를 안전하게 다루기 위한 메커니즘인데, CPU가 바뀔 수 있으니 관련 상태를 갱신해주는 작업입니다.
③ __set_task_cpu(p, select_task_rq(p, task_cpu(p), WF_FORK)); (하이라이트!)
여기가 바로 전공 서적의 알고리즘이 실체화되는 지점입니다.
• select_task_rq(...): "이 자식 프로세스를 실행하기에 가장 한가하거나 적합한 CPU가 어디니?"라고 스케줄러에게 물어보는 함수입니다. 여기서 부하 분산(Load Balancing) 알고리즘이 돌아갑니다.
• WF_FORK: 함수에게 "지금 이거 fork 상황이야"라고 알려주는 플래그입니다. 새로 태어난 놈이니 더 과감하게 비어있는 코어로 보낼 수 있겠죠.
• __set_task_cpu: 결정된 CPU 번호를 task_struct에 실제로 써넣습니다. 주석에 있듯, 아직 프로세스가 완벽히 세팅된 게 아니라서 정식 절차(migrate_task_rq) 대신 내부용 함수(__)를 씁니다.
(3) 왜 여기서 하나요? (주석의 의미)
주석이 아주 친절하게 설명해주고 있는데, 시니어 급이라면 이 이유를 꼭 챙기셔야 합니다.
1) cpus_ptr 변화: fork 과정 중에 프로세스가 실행 가능한 CPU 목록(Affinity)이 바뀔 수 있습니다.
2) Hotplug 문제: CPU는 언제든 꺼질 수 있습니다(Hotplug). 너무 일찍 CPU를 정해버리면, 정작 깨우려고 할 때 그 CPU가 사라졌을 수도 있죠.
• 즉, 최대한 늦게(깨우기 직전에) 결정하는 것이 가장 안전하다는 뜻입니다.
(4) 경력직을 위한 통찰 (Expert View)
이 코드를 보면서 "아, 이게 오디오 레이턴시에 영향을 주겠구나"라고 연결해 보세요.
• 만약 select_task_rq가 자식 프로세스를 부모와 다른 코어로 보내면? -> 캐시가 차갑게 식어서(Cache Cold) 초기 실행 속도가 살짝 느려질 수 있습니다.
• 하지만 같은 코어에 두면? -> 부모와 자식이 한 코어를 놓고 싸우느라 전체적인 성능이 떨어질 수 있습니다.
이 미묘한 밸런스를 잡는 로직이 바로 저 select_task_rq 안에 들어있습니다.
결론: 지금 보시는 코드는 "멀티코어 환경에서 갓 태어난 프로세스에게 최적의 보금자리(CPU)를 찾아주는 첫 번째 공식 절차"입니다. 이 줄이 끝나면 드디어 CPU 번호가 확정되고, 곧이어 실행 큐(Runqueue)에 들어가게 됩니다.
이후에 나오는 activate_task나 enqueue_task 부분까지 쭉 보시면, 이론으로만 배우던 "큐에 삽입"이 어떻게 메모리 구조로 바뀌는지 완벽히 이해되실 겁니다!
💡학습 속도를 높이는 3가지 팁
지금처럼 소스 코드를 분석하시되, 다음을 섞어보시면 훨씬 효율적입니다.
1. 시각화 습관: 지금 하시는 것처럼 함수의 호출 스택(Call Stack)을 직접 그려보세요. kthread_create -> kthreadd 사이의 관계를 그림으로 그려두면 나중에 코드를 안 봐도 흐름이 기억납니다.
2. 질문 던지기: "왜 WRITE_ONCE를 썼을까?" 같은 의문이 생길 때, 해당 라인의 커밋 로그(git blame)를 보세요. 리누스 토발즈나 핵심 개발자들이 왜 그렇게 고쳤는지 이유가 적혀 있는데, 이게 최고의 교과서입니다.
3. 실습 병행: 이론만 파면 금방 지칩니다. 지금 쓰고 계신 보드에서 간단한 커널 모듈을 직접 올려보며, 오늘 공부한 kthread가 top 명령어로 어떻게 보이는지 확인해 보세요.
'Embedded : : Linux > : : Linux Kernel' 카테고리의 다른 글
| 커널과 모듈의 개념 (0) | 2024.10.11 |
|---|---|
| [프로세스] 프로세스의 종료 과정 분석 (0) | 2024.10.11 |
| [프로세스] 커널 쓰레드 (0) | 2024.10.10 |
| [프로세스] 프로세스 생성 (0) | 2024.10.10 |
| [프로세스] 프로세스 확인하기 (0) | 2024.10.10 |