
피드포워드 네트워크(Feed-Forward Network, FFN)은 인공신경망 아키텍처 중 가장 기본이자 근간이 되는 형태이다.
이 네트워크의 핵심적인 특징은 정보의 흐름이 엄격하게 단방향(unidirectional)으로만 이루어진다는 점에 있다. 데이터는 입력층(Input Layer)에서 시작하여, 존재한다면 하나 이상의 은닉층(Hidden Layer)을 거치고, 최종적으로 출력층(Output Layer)에 도달한다.
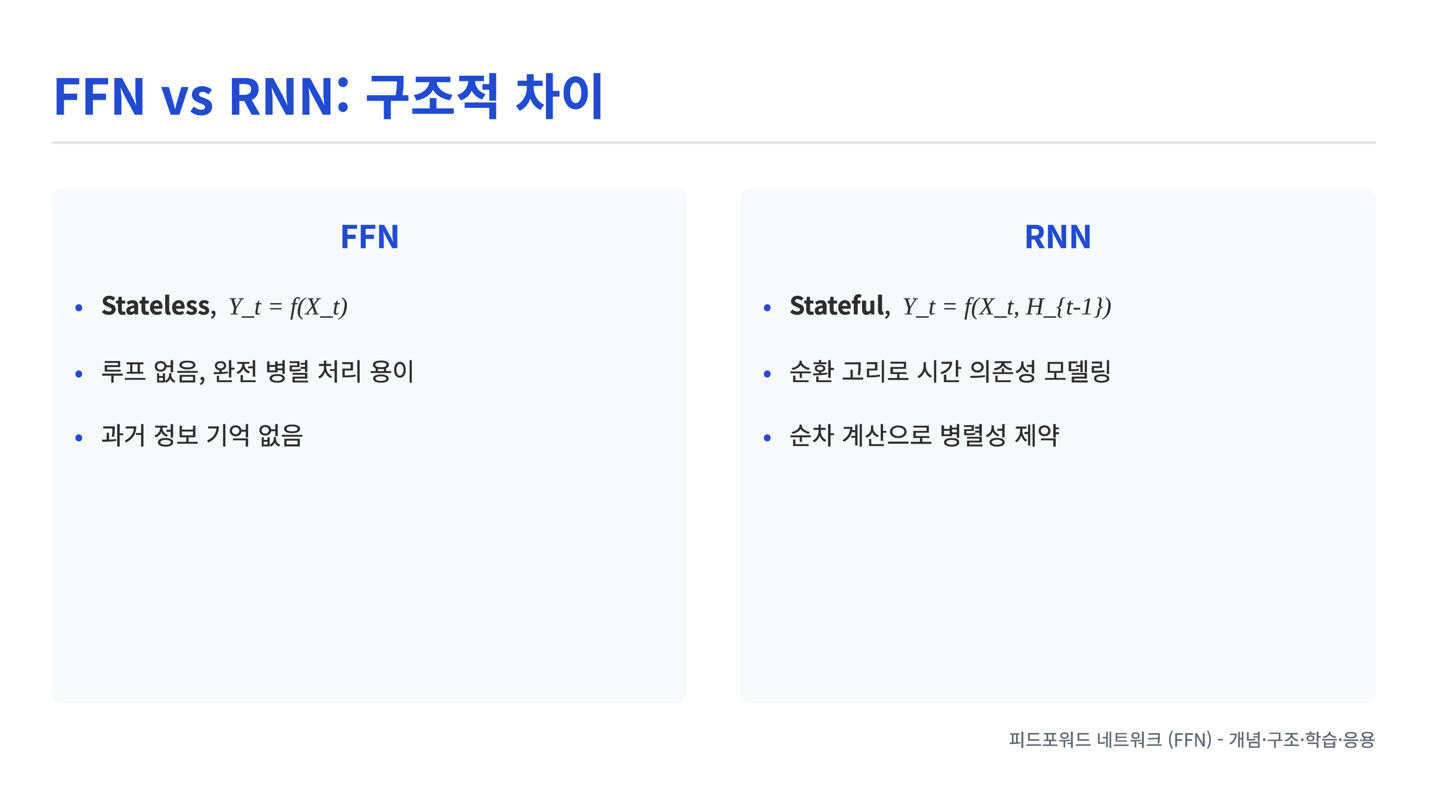
이 과정에서 정보는 절대로 역방향으로 흐르거나 이전 단계의 처리 노드로 되돌아가지 않는다. 이러한 비순환적(acyclic) 구조, 즉 네트워크 내에 어떠한 형태의 순환이나 루프(loop)도 존재하지 않는다는 점은 피드포워드 네트워크를 순환 신경망(Recurrent Neural Network, RNN)과 근본적으로 구별짓는 기준이 된다.
RNN은 의도적으로 순환 구조를 도입하여 이전 시점의 정보가 현재의 처리에 영향을 끼치도록 설계하는 반면, FFN은 각 입력에 대해 독립적이고 정적인(static) 계산을 수행한다. FFN는 본질적으로 입력 X를 출력 Y로 매핑하는 복잡한 함수 Y = f(X)를 근사(approximate)하려는 시도이며, 이전 입력에 대한 기억(memory)을 가지지 않는다. 이러한 비순환적 설계는 단순히 구조의 단순성을 위한 선택이 아니라, 딥러닝의 핵심 학습 알고리즘인 역전파(Backpropagation)를 적용하기 위한 필수적인 전제조건이다.
만일, 출력 정보가 다시 입력으로 피드백되어 자신을 수정하는 루프가 존재한다면, 이는 미분 과정에서 무한 루프를 형성하게 되어 표준적인 역전파 방식으로는 그래디언트(gradient)를 계산하는 것이 불가능해지기 때문이다. 따라서 FFN의 '피드 포워드'라는 제약은 사실상 경사 하강법 기반의 학습 가능성을 보장하기 위한 구조적 선택이라 할 수 있다.
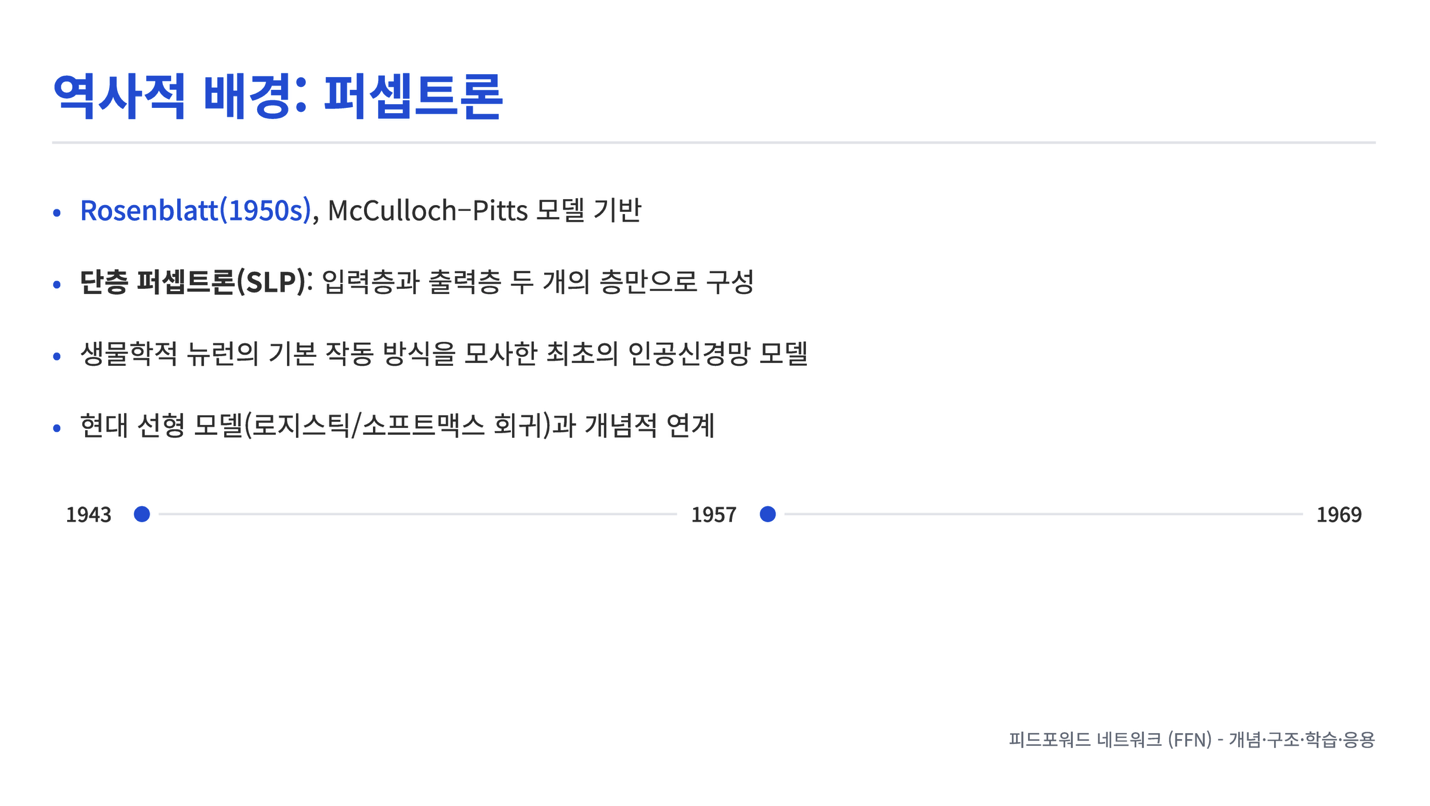
이러한 피드포워드 네트워크의 개념은 1950년대 프랭크 로젠블라트(Frank Rosenblatt)가 워런 맥컬록과 월터 피츠의 초기 연구를 기반으로 제안한 퍼셉트론(Perceptron)에서 찾을 수 있다. 초기 형태인 단층 퍼셉트론(Single-Layer Perceptron, SLP)은 이름 그대로 입력층과 출력층이라는 두 개의 층만으로 구성되었다. 로지스틱 회귀나 소프트맥스 회귀와 같은 현대의 많은 선형 모델들도 이러한 단층 퍼셉트론의 한 형태로 간주할 수 있다.
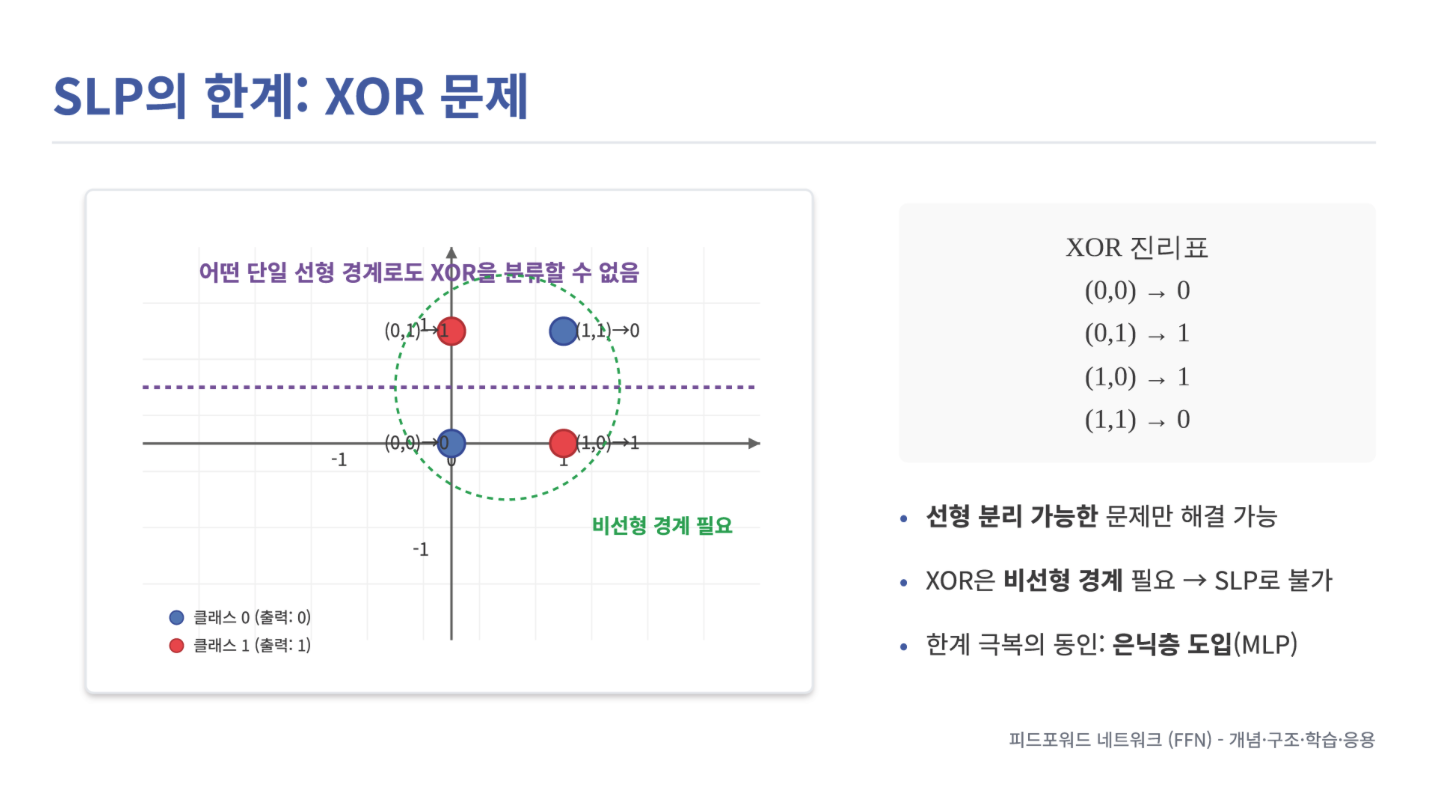
하지만 단층 퍼셉트론은 치명적인 한계를 지녔는데, 바로 선형적으로 분리 가능한(Linearly Separable) 문제만을 해결할 수 있다는 점이었다. 이로 인해 두 입력이 다를 때만 1을 출력하는 XOR Gate 문제와 같은 단순한 비선형(non-linear) 패턴 조차 학습할 수 없었다.
이 한계를 극복하기 위해 등장한 것이 바로 다층 퍼셉트론(MultiLayer Perceptron, MLP)이며, 이는 오늘날 우리가 FFN이라고 부르는 구조의 실질적인 표준이다. MLP는 입력층과 출력층 사이에 하나 이상의 은닉층(Hidden Layer)을 추가한 구조를 가진다. 은닉층의 도입은 단순히 네트워크의 깊이를 더하는 것을 넘어, FFN의 표현력을 기하급수적으로 증가시키는 핵심적인 역할을 한다. 은닉층은 입력 데이터를 선형적으로 분리하기 어려운 원래의 공간에서, 비선형 변환을 통해 선형 분리가 가능한 고차원의 새로운 '특성공간(Feature Space)'으로 매핑하는 작업을 수행한다. XOR 문제가 AND, NAND, OR게이트의 조합과 같은 복잡한 비선형 변환을 구현함으로써 단층 퍼셉트론의 한계를 돌파한 것이다.
FFN의 미시적 작동 원리를 이해하기 위해서는 개별 뉴런(neuron) 또는 노드(node)의 연산 과정을 살펴보아야 한다. 다층 퍼셉트론에서 각 층은 다수의 뉴런으로 구성되며, 한 층의 모든 뉴런은 일반적으로 이전 층의 모든 뉴런과 연결된다 (이를 '완전 연결층, Fully Connected Layer')라 부른다.
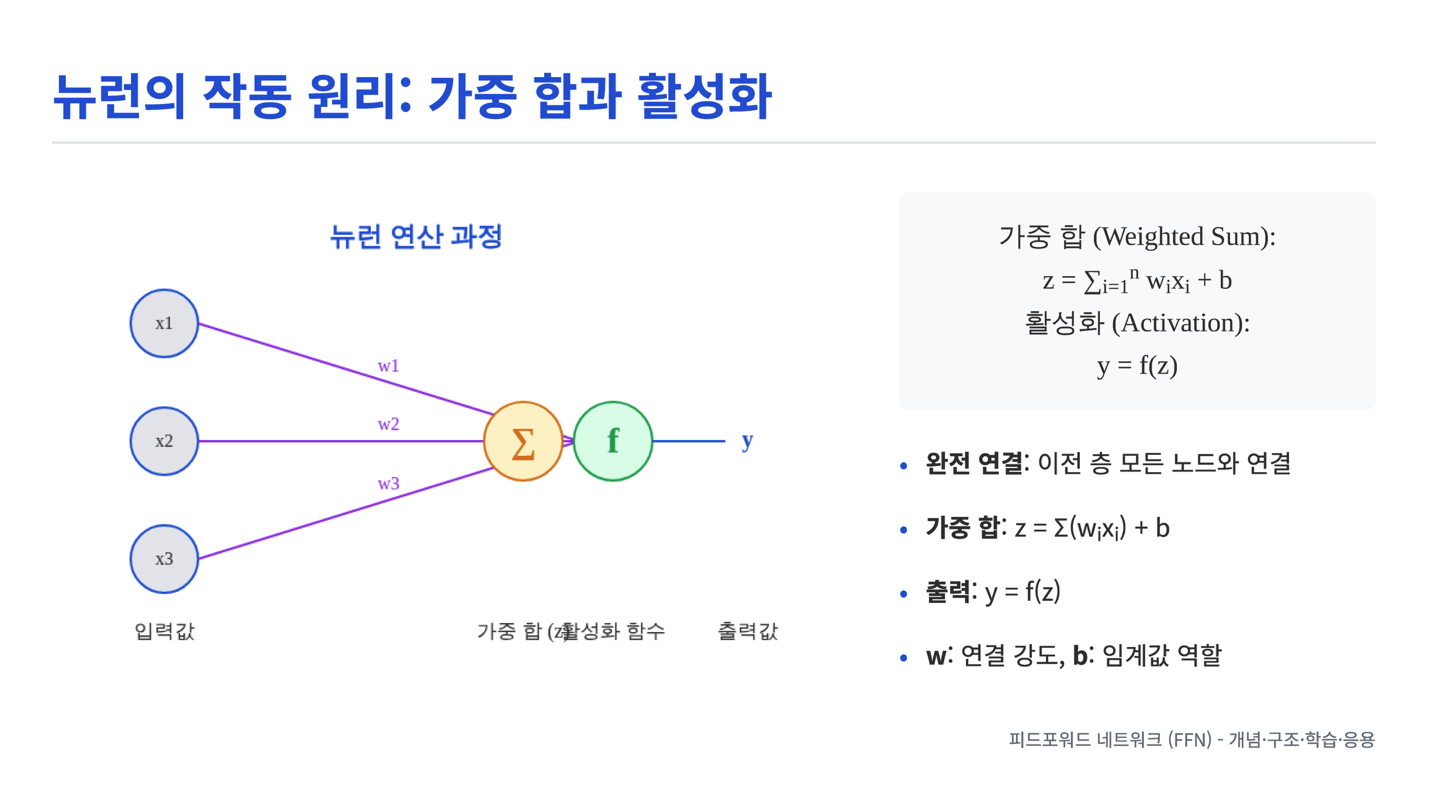
각 뉴런은 두 단계의 연산을 순차적으로 수행한다. 첫 번째 단계는 '가중 합(weighted sum)'이다. 뉴런은 이전 츠으이 뉴런들로부터 입력 신호(x1, x2, ..., xn)를 전달받아, 각 신호에 고유한 '가중치(weight, w1, w2, ..., wn)'fㅡㄹ 곱한 뒤 이들을 모두 더한다. 그리고 여기에 '편항(bias, b)' 이라는 상수 값을 추가한다. 이 과정을 수식으로 표현하면 z=($sigmanwixi)+b$ 가 된다. 여기서 가중치(w)는 각 입력 신호가 현재 뉴런에 미치는 '영향력' 또는 '연결 강도'를 의미하며, 편향(b)은 뉴런이 얼마나 쉽게 '활성화(fire)'되는지를 조절하는 일종의 임계값(threshold) 역할을 한다. 신경망의 '학습'이란 결국 주어진 데이터를 가장 잘 설명할 수 있는 최적의 가중치와 편향 파라미터들을 찾는 과정이다. 두 번째 단계는 이 가중 합의 결과 z를 '활성화 함수(activation function)' f(·)에 통과시켜 최종 출력 신호 $y=f(z)=f((∑wixi)+b)를 생성하는 것이다.
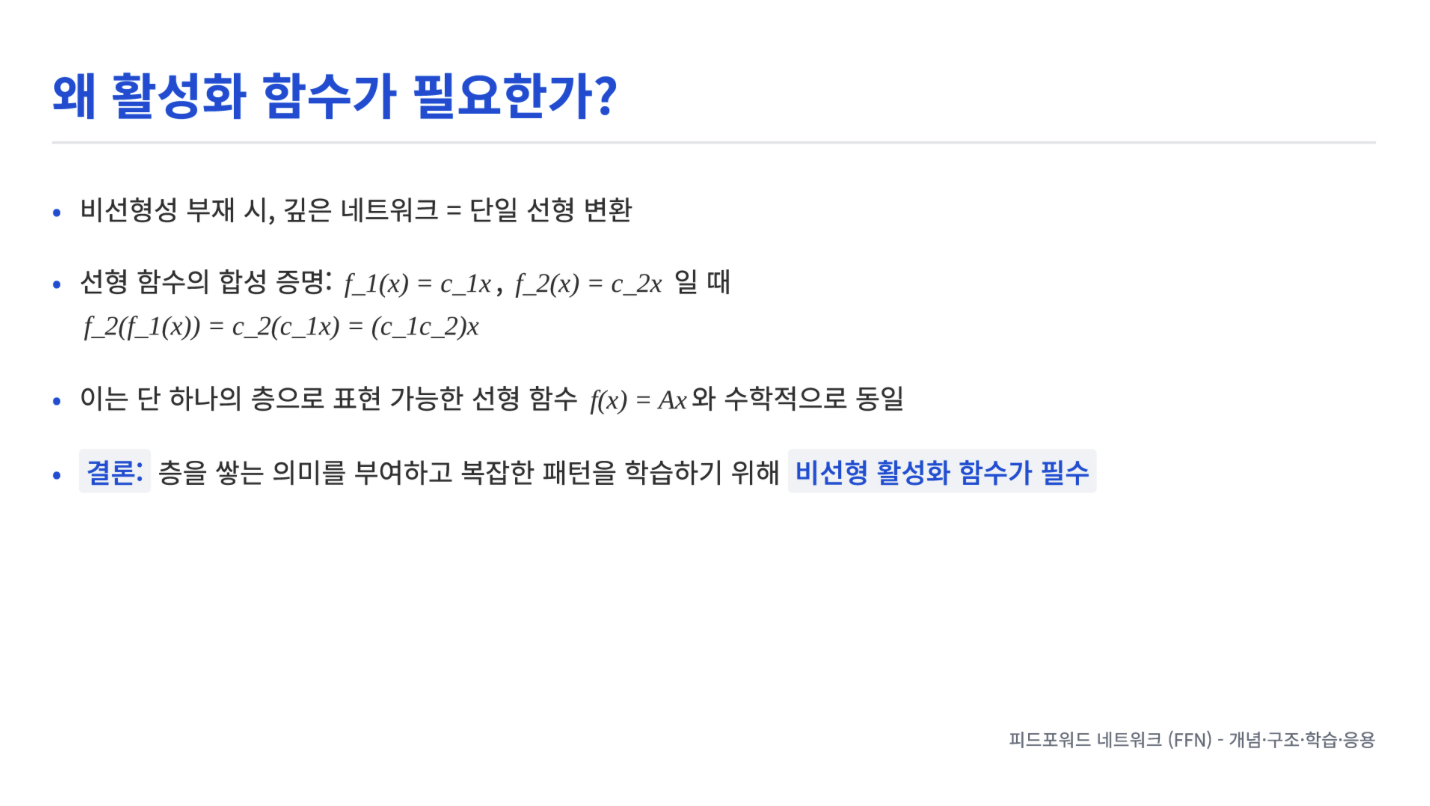
활성화 함수의 사용은 FFN이 복잡한 패턴을 학습하는 데 있어 절대적으로 중요하다. 만약 활서오하 함수가 존재하지 않거나, f(x)=cx와 같은 '선형 함수(lienar function)'가 사용된다면, 신경망의 층을 아무리 깊게 쌓는다고 해도 그 전체 네트워크는 결국 하나의 거대한 선형 변환과 동일해지기 때문이다.
예를 들어, $f_1(x)=c_1x, f2(x)=c2x라면, f2(f1(x))=c2(c1x)=(c1c2)x$가 되어, 이는 단 하나의 층으로 표현 가능한 선형 함수 f(x)=Ax와 수학적으로 동일하다. 즉, 선형 활성화 함수를 사용하는 100층짜리 네트워크는 1층짜리 단층 퍼셉트로노가 동일한 표현력밖에 갖지 못하며, 층을 쌓는(deep) 이점을 전혀 살릴 수 없다. 따라서 복잡한 비선형 데이터 패턴을 모델링하고 층을 깊게 쌓는 것의 의미를 부여하기 위해서는 반드시 '비선형(non-linear)' 활서오하 함수가 각 뉴런에 적용되어야 한다. FFNdㅢ 진정한 힘은 '선형 변환(가중 합)'과 '비선형 변환(활성화 함수)'이라는 두 가지 연산을 여러 층에 걸쳐 연속적으로 중첩함으로써, 입력 공간을 점진적으로 '접고' '구부려' 매우 복잡한 형태의 결정 경계(Decision Boundary)를 만들어내는 능력에서 나온다. 초기 퍼셉트론에서 사용된 헤비사이드 계딴 함수(Heaviside Step Function)는 비선형이기는 했으나, 특정 지점을 제외한 모든 구간에서 미분값이 0이 되어 경사 하강법 기반의 학습이 불가능했다.
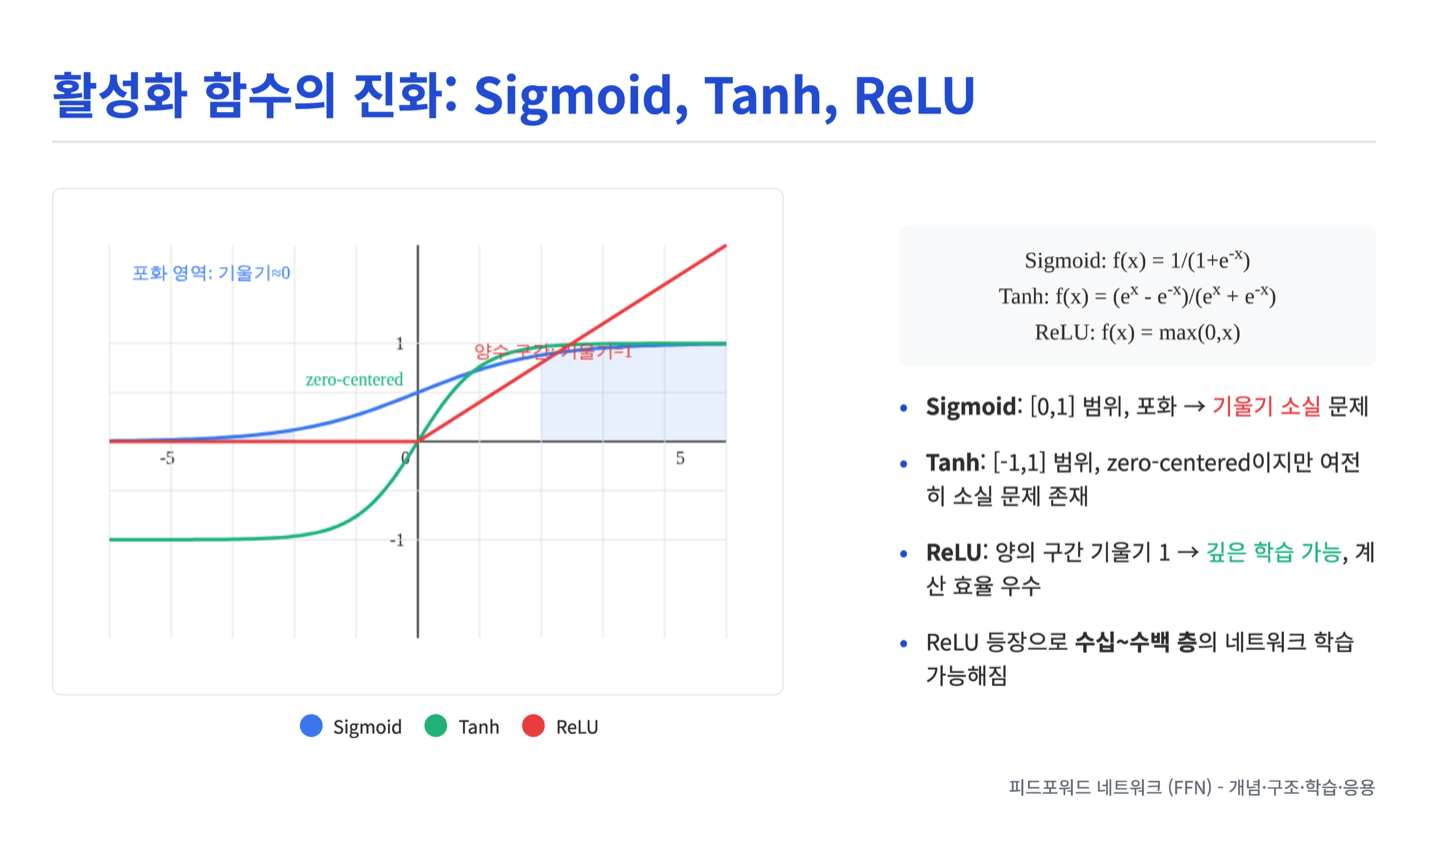
이러한 이유로 경사 하강법 기반의 학습을 가능하게 하는, 미분 가능한 비선형 활성화 함수들이 개발되었다. 초기 딥러닝에서 널리 사용된 함수는 시그모이드(Sigmoid) 함수와 하이퍼볼릭 탄젠트(Tanh) 함수이다. 시그모이드 함수 $f(x)=1/(1+e-_x )$는 모든 실수 입력을 사이의 값으로 압축하며, Tanh 함수는 이를 변형하여 [-1, 1] 사이의 값으로 압축한다. Tanh는 시그모이드와 달리 출력이 0을 중심(zero-centered)으로 하기 때문에, 학습 과정에서 그래디언트가 한쪽 방향으로만 치우치는 현상을 방지하여 시그모이드보다 더 효율적인 학습을 가능하게 했다.
하지만 이 두 함수는 공통적으로 '기울기 소실(Vanishing Gradient Problem)'이라는 치명적인 약점을 안고 있었다. 두 함수 모두 입력값의 절댓값이 커질수록(즉, 그래프의 양쪽 끝으로 갈수록) 함수가 '포화(saturate)'되어 기울기(미분값)가 0에 수렴한다. 역전파 과정에서 이 0에 가까운 작은 기울기들이 여러 층을 거치며 계속 곱해지면, 입력층에 가까운 초기 레이어들로 갈수록 그래디언트 신호가 지수적으로 작아져 거의 0에 이러게 된다. 그래디언트가 0이 되면 가중치 업데이트가 멈추고, 해당 뉴런들은 더이상 학습을 진해앟지 못하게 된다. 이 기울기 소실 문제는 FFN을 비롯한 신경망을 '깊게(Deep)' 쌓는 것을 방해하는 가장 큰 장애물이었다.
이 문제를 획기적으로 해결한 것이 바로 렐루(ReLU, Rectified Linear Uni) 함수이며, f(x)=max(0, x)라는 지극히 단순한 형태로 정의된다. ReLU는 입력이 0보다 크면 그 값을 그대로, 0보다 작으면 0을 출력한다. 이로 인해 입력이 양수인 구간에서는 기울기가 항상 1로 일정하며, 아무리 층이 깊어져도 기울기가 소실되지 않는다. 또한 exp와 같은 복잡한 연산이 없어 계산 속도가 매우 빠르다는 장점도 있다. ReLU의 등장은 신경망의 깊이를 수십, 수백 층까지 쌓는 것을 가능하게 한 핵심 기술 혁신 중 하나가 되었다.
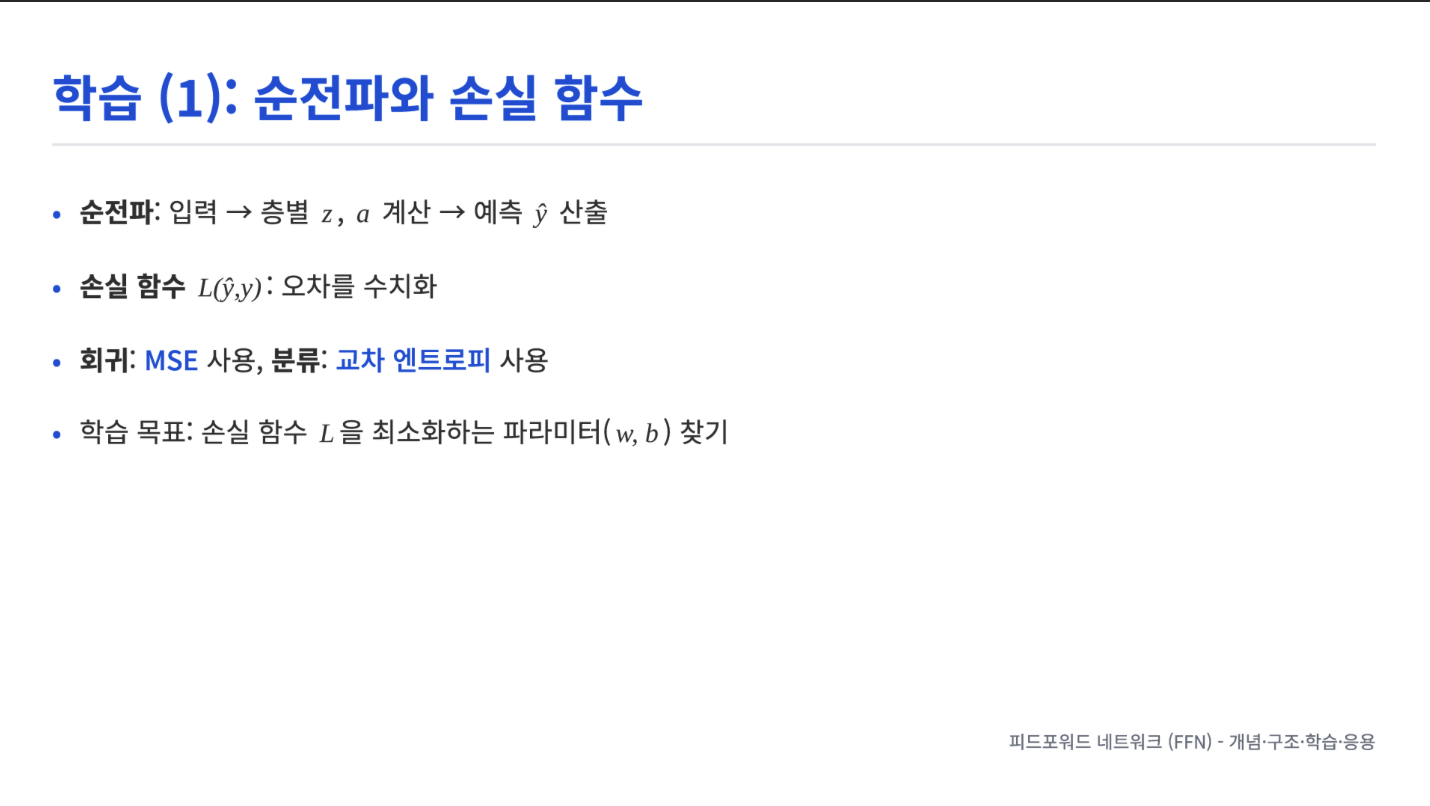
FFN의 학습 메커니즘은 '순전파(Forward Propagation)'와 역전파(Backpropagation)'라는 두 가지 핵심 단계의 반복적인 순환을 통해 이루어진다. 먼저 순전파 단계에서는, 학습 데이터(입력 X)가 네트워크의 입력층으로 주입된다. 이 데이터는 네트워크에 정의된 대로, 각 층의 뉴런에서 '가중 합'과 '활성화 함수' 연산을 순차적으로 거치면서 은닉층들을 통과한다. 이 과정에서 출력층에 도달할 때까지 계쏙되며, 최종적으로 네트워크의 '예측값(y^)'을 산출하게 된다. 이렇게 예측값이 나오면, 다음으로는 이 예측값이 실제 정답(target y)과 얼마나 다른지를 정량적으로 측정해야 한데, 이를 '손실 함수(Loss Function)' 또는 '비용 함수(Cost Function)'라 한다. 손실 함수는 예측값과 실제값 사이의 '오차(error)' 또는 '격차(gap)'를 하나의 숫자로 계산하여 반환한다.
예를 들어, 회귀 문제에서는 주로 평균 제곱 오차(Mean Squared Error, MSE)가 사용되며, 분류 문제에서는 교차 엔트로피 오차(Cross-Entropy Error)가 널리 사용된다. 신경망 학습의 궁극적인 목표는 이 손실 함수의 값을 '최소화(Minimize)'하는 파라미터(가중치 w와 편향 b)의 조합을 찾는 것이다. 즉, 손실 함수는 현재 네트워크의 파라미터가 얼마나 '잘못'되었는지를 알려주는 동시에, '어느 방향으로' 개선되어야 할지를 판단하는 지표가 된다.
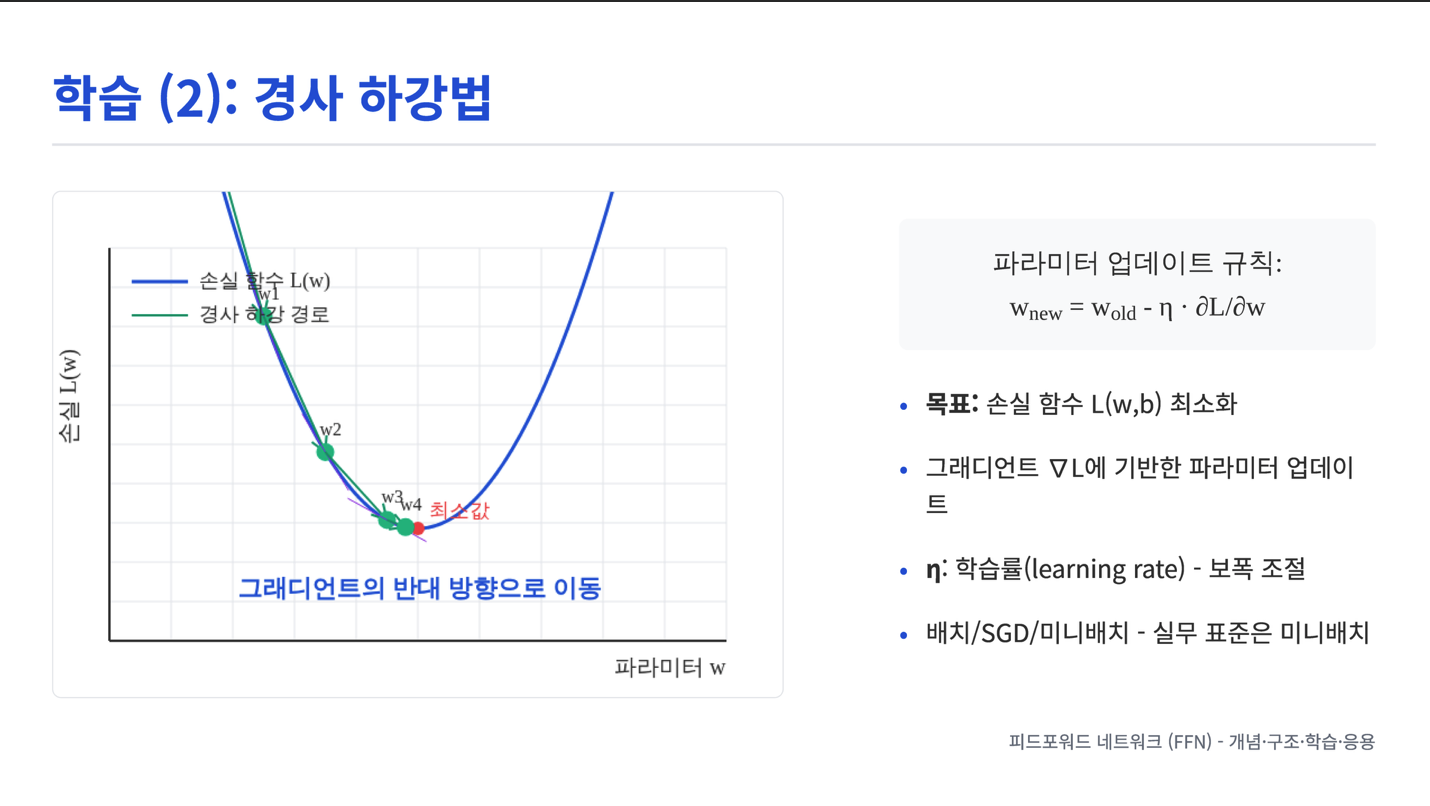
손실함수라는 '목표'가 정해지면, 이 목표(손실의 최소화)를 달성하기 위한 '전략'이 필요하며, 이 전략이 바로 '경사 하강법(Gradient Descent)'이다. 손실 함수 L을 수백만 개(혹을 수십억 개)의 모든 파라미터(w, b)에 대한 다변수 함수 L(w, b)라고 상상해보자. 이 함수의 현재 지점에서 '그래디언트(gradient, ▽L)'는 함수의 값이 가장 가파르게 증가하는 방향을 나타내는 벡터이다. 이 그래디언트는 L을 각 개별 파라미터(ex: w_ij)로 편미분(partial derivative)한 값(∂L / ∂w_ij)들의 집합으로 구성된다. 손실을 최소화하는 것이 목표이므로, 우리는 이 그래디언트 벡터가 가리키는 방향의 정반대 방향(즉, 가장 가바르게 감소하는 방향)으로 파라미터를 조금씩 이동(업데이터)시킨다. 이 이동의 보폭(step size)은 '학습률(learning rate, η)'이라는 하이퍼 파라미터에 의해 조절된다. 즉, $w_new = w_old - η·(∂L / ∂w_old )$와 같은 업데이트 규칙이 모든 파라미터에 대해 동시에 적용된다. 이 과정을 손실 값이 더 이상 줄어들지 안흔ㄴ 지점(최소값)에 수렴할 때까지 반복하는 것이 경사 하강법의 핵심이다. 전체 데이터를 한 번에 사용하여 그래디언트를 계산하면 '배치(Batch) 경사 하강법', 데이터 한 개마다 계산하면 '확률적(Stochastic) 경사 하강법(SGD)', 그리고 현실적인 절충안으로 작은 묶음(mni-batch) 단위로 계산하면 '미니 배치(Mini-Batch) 경사 하강법'이라 부르며, 현재는 미니 배치 방식을 가장 표준적으로 사용한다.
여기서 가장 중요하고도 어려운 질문이 남는다. 경사 하강법은 그래디언트 ▽L을 안다고 '가정'하지만, 수백만 개의 파라미터를 가진 FFN에서 이 모든 편미분값(∂L / ∂w_ij )들을 어떻게 효율적으로 계산할 것인가?
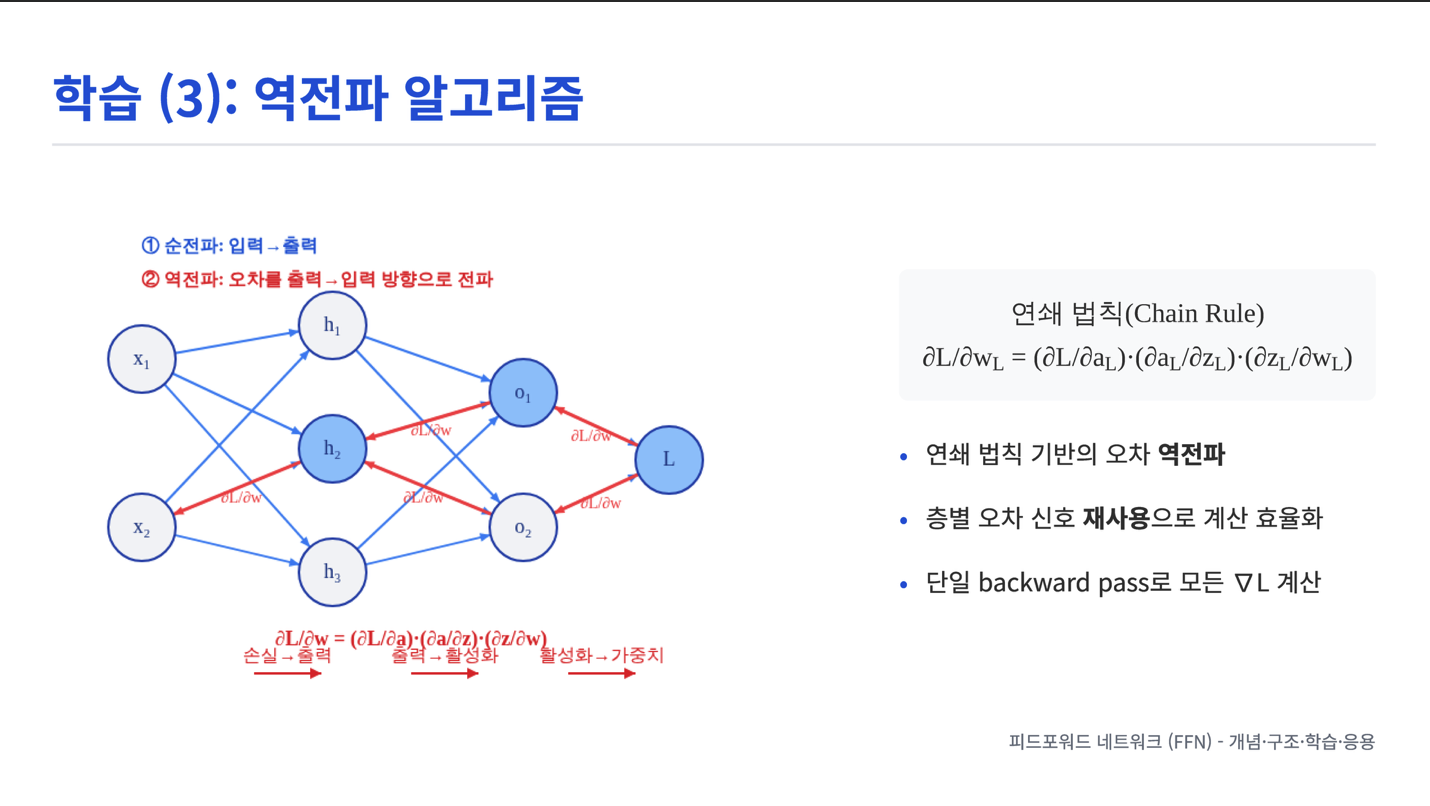
이 질문에 대한 답이 바로 '역전파(Backpropagation)' 알고리즘이다. 역전파는 그 자체로 학습 알고리즘이 아니라, 경사 하강법에 필요한 그래디언트를 계산하는 매우 효율적인 알고리즘이다. 1986년 럼멜 하트, 힌튼, 윌리엄스에 의해 그 중요성이 재조명된 이 알고리즘은, 이름(오차 역전파) 그대로 손실 L이라는 오차 신호를 네트워크의 출력층에서 입력층 방향으로 '거꾸로' 전파시킨다. 역전파는 미적분의 '연쇄 법칙(Chain Rule)'을 기계적으로, 그리고 재귀적으로 적용하는 방식이다. 예를 들어, 출력층 가중치 $w_L$ 이 손실 L에 미치는 영향($∂L/∂w_L$)을 계산하기 위해서는, L이 출력층 활성화 $a_L$에 미치는 영향($∂L/∂a_L$)과, $a_L$이 가중 합 $Z_L$에 미치는 영향($∂a_L/∂Z_L$), 그리고 $Z_L$이 가중치 $W_L$에 미치는 영향($∂Z_L/∂w_L$)을 연쇄적으로 곱해야 한다. $(∂L/∂w_L = (∂L/∂a_L)·(∂a_L/∂Z_L)·(∂Z_L/∂w_L)$. 역전파는 이 과정을 체계화하여, 출력층에서 계산한 오차 신호($∂L/∂a_L$)를 이용해 바로 이전 층(L-1)의 오차 기여도($∂L/∂a_L-1$)를 계산하고, 이 과정을 입력층에 도달할 때까지 반복한다. 이 방식의 핵심은 중간 계산 결과(각 층의 오차 신호)를 재사용 하여, 중복 계산을 피하고 네트워크의 모든 파라미터에 대한 그래디언트를 단 한 번의 역방향 패스(Backward Pass)로 효율적으로 계산해낸다는 데 있다.
결국 딥러닝의 학습은 ① 현재 파라미터로 '순전파'를 수행하여 예측값을 얻고, ② '손실 함수'로 오차 L을 계산한 뒤, ③ '역전파'를 이용해 L에 대한 모든 파라미터의 그래디언트 ▽L을 계산하고, ④ '경사 하강법'으로 이 그래디언트를 이용해 파라미터를 업데이트 하는 네 단계의 얽힌 과정을 수 없이 반복하는 것이다.
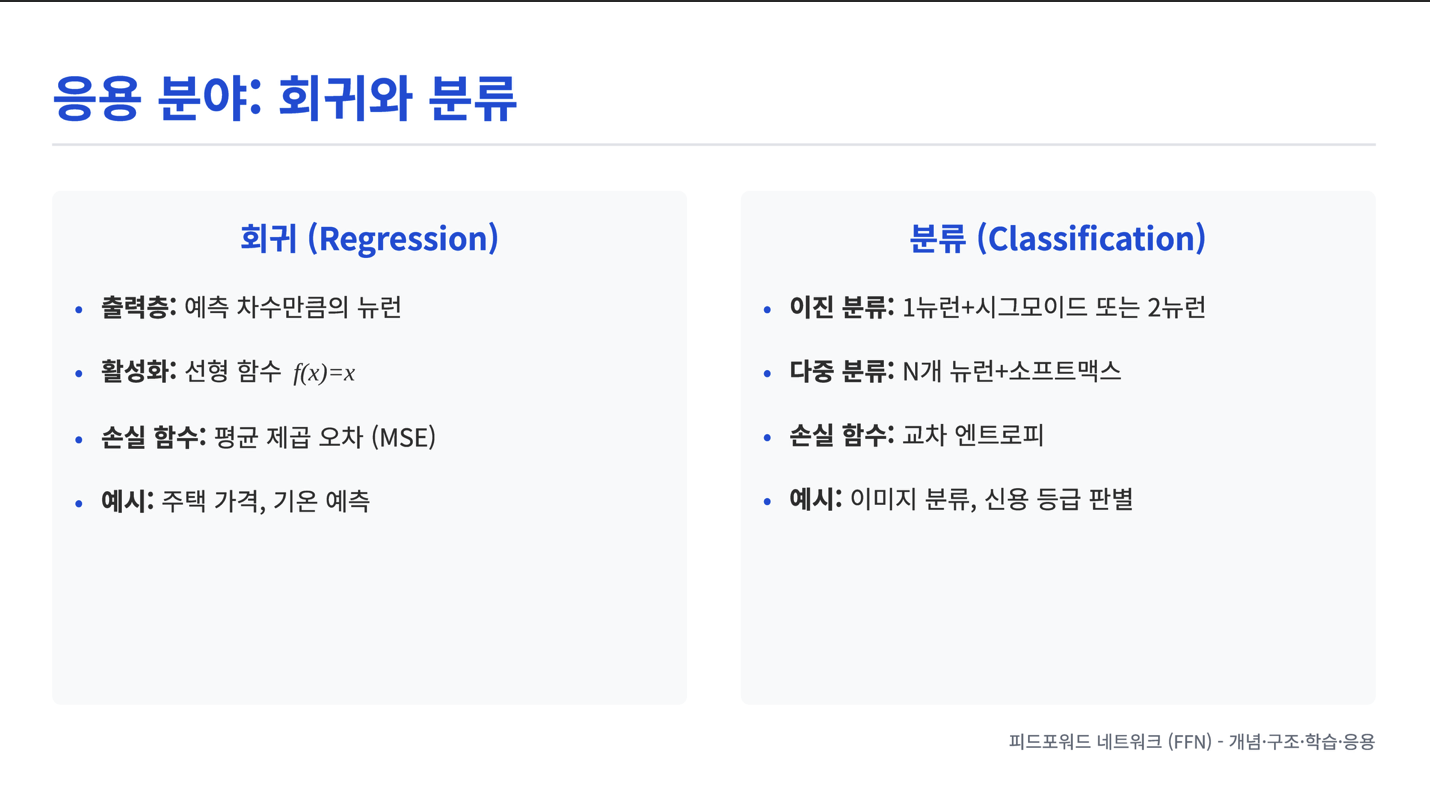
반면, 분류 문제는 이미지를 보고 '불가사리'인지 '성게'인지 판별하거나, 금융 프로필을 보고 신용등급을 판별하는 것 처럼 데이터가 속한 '범주(Class)'를 예측하는 과제이다. 이 경우, FFN의 출력층은 예측하려는 범주의 개수(N)만큼의 뉴런을 가진다. 만약 범주가 2개인 이진 분류(Binary Classification)라면, 출력층에 2개의 뉴런(혹은 1개의 뉴런과 시그모이드 함수)을 두고 시그모이드(Sigmoid) 활성화 함수를 사용하여 각 클래스에 속할 확률(0 ~ 1)을 출력하도록 설계할 수 있다. 만약 범주가 2개보다 많은 다중 클래스 분류(Multi-Class Classification)라면, 출력층 N개의 뉴런에 '소프트맥스(Softmax)' 활성화 함수를 적용하는 것이 표준이다. 소프트맥스 함수는 N개의 뉴런이 출력하는 임의의 점수(logit)를 입력받아, 이들을 '총 합이 1이 안되는 확률 분포'로 변환해준다. 네트워크의 최종 예측은 이 확률분포에서 가장 높은 확률값을 가진 뉴런(인덱스)에 해당하는 클래스가 된다. 이 경우 손실 함수로는 교차 엔트로피(Cross-Entropy)가 사용된다.
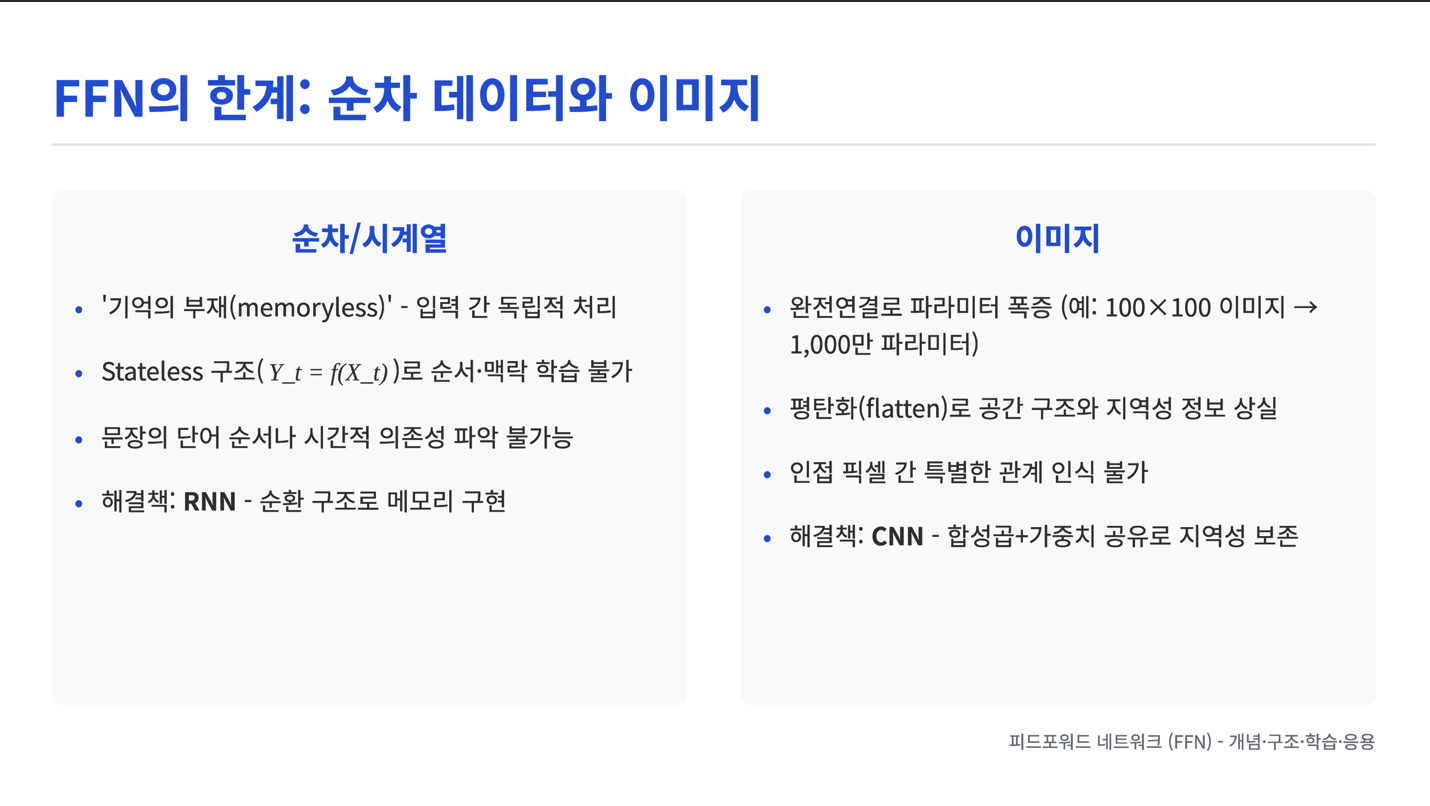
이처럼 FFN은 강력한 범용성을 지니지만, 동시에 명확하고 근본적인 한계점을 가지고 있다. FFN의 가장 치명적인 한계는 '기억의 부재(memoryless)', 즉, 각 입력 데이터를 이전 또는 이후의 데이터와 완전히 독립적인(Independent) 사건으로 취급한다는 점이다. 이로 인해 FFN은 입력 데이터간의 '순서'나 시간적 맥락(Temporal Cotnext)'이 핵심적인 의미를 갖는 순차적 데이터(Sequential Data) 또는 시계열 데이터(Time-Series Data)를 처리하는 데 본질적으로 부적합하다.
예를 들어, "나는 어제 학교에 갔다"라는 문작을 FFN에 입력하면, FFN은 각 단어를 개별적으로 처리할 뿐 '어제'라는 단어와 '갔다'라는 시제가 어떻게 연관되는지, 혹은 단어의 순서(you, say)와 (say, you)가 어떻게 다른 의미를 생성하는 지 파악할 수 없다. FFN의 구조 $(
Y_t = f(X_t) )$는 현재 입력 $X_t$만으로 현재 출력 $Y_t$를 결정하는 'Stateless' 아키텍쳐이기 때문이다.
이러한 한계를 극복하기 위해 등장한 것이 바로 순환 신경망(Recurrent Neural Network, RNN)이다. RNN은 네트워크 내부에 '순환 고리(recurrent loop)'를 의도적으로 설계하여, 이전 타임스텝 (t-1)의 '은닉 상태(Hidden State, $H_t-1 )'를 현재 타임스텝(t)의 입력($X_t$)와 함께 받아 처리한다. 이 은닉상태 H가 일종의 '메모리' 역할을 수행하며, $Y_t = f(X_t , H_t-1 )$라는 'Stateful' 아키첵쳐를 구현한다. 이를 통해 RNN은 FFN이 불가능했던 시간적 종속성과 순차적 패턴을 학습할 수 있게 된다.
FNN은 순차적 데이터 뿐만 아니라, 이미지와 같은 고차원의 공간적(Spatial) 데이터를 처리하는 데에도 심각한 한계를 보인다. 이 한계는 두 가지 측면에서 발생한다.
첫째, FFN은 기본적으로 '완전 연결(Fully Connected)' 구조를 가지기 때문에, 입력 데이터의 차원이 커지면 파라미터의 수가 기하급수적으로 폭증한다. 예를 들어, 100x100 픽셀의 작은 흑백 이미지(입력 뉴런 10,000개)를 1,000개의 뉴런을 가진 첫 번째 은닉층에 연결하는 데에만 10,000 x 1,000 =10,000,000 1,000만 개의 가중치 파라미터가 필요하다. 이는 엄청난 계산 비용을 유발할 뿐만 아니라, 과적합(Overfitting)을 피하기 어렵게 만든다.
둘째, FFN에 2D 이미지를 입력하기 위해서는 이미지를 1D 벡터로 '평탄화(Flatten)' 하는 과정이 필요한데, 이 과정에서 픽셀 간의 '공간적 인접성'이나 '지역적(Local) 구조'에 대한 정보가 완전히 파괴된다. FFN에게는 이미지의 왼쪽 위 픽셀과 바로 그 오른쪽 픽셀의 관계가, 왼쪽 위 픽셀과 오른쪽 아래 픽셀의 관계와 하등 다를 바가 없다.
이러한 한계를 극복한 아키텍쳐가 바로 합성곱 신경망(Convolutional Neural Network, CNN)이다. CNN은 두 가지 혁신적인 아이디어를 도입했다.
하나는 '합성곱(Convolution)' 연산으로, 3x3이나 5x5 같은 작은 '커널(Kernel)' 또는 '필터'가 이미지 전체를 훑고 지나가며(Sliding) 선, 모서리, 질감과 같은 '지역적 특징'을 감지한다.
다른 하나는 '가중치 공유(Weight Sharing)'로, 이 작은 커널(즉, 가중치 집합)이 이미지의 모든 위치에서 동일하게 공유된다. '수직선'을 감지하는 커널 하나가 이미지의 모든 영역에 적용되는 것이다. 이는 FFN 대비 파라미터 수를 극적으로 줄여주며, 동시에 '패턴이 이미지의 어디에 있든(Translation Invariance)' 동일하게 감지할 수 있도록 한다.
흥미롭게도, 대부분의 CNN 아키텍쳐는 여러 층의 합성곱과 풀링(Pooling)을 거쳐 고차원의 특징 맵(Feature Map)을 추출한 뒤, 이 맵을 '평탄화'하여 마지막에 FFN(완전 연결층)에 전달함으로써 최종적인 분류 또는 회귀 결정을 내린다. 이는 FFN이 '공간적 특징 추출기'로서는 비효율적이지만, '이미 잘 추출된 고차원 특징들을 종합하여 최종 결론을 내리는 의사결정자'로서는 여전히 강력하고 유용함을 시사한다.
RNN과 CNN의 등장으로 인해 FFN은 한동안 구식 아키텍쳐나 특정 용도(CNN의 마지막 분류기 등)로만 사용하는 것 처럼 보였다. 하지만 FFN은 2017년 'Attention Is All You Need' 논문을 통해 등장한 '트랜스포머(Transformer)' 아키텍쳐의 핵심 구성요소로 화려하게 부활하며 현대 딥러닝의 중심에 다시 서게 되었다.
트랜스포머는 자연어 처리를 비롯한 거의 모든 AI분야의 표준 아키텍쳐가 되었으며, 그 기본 블록은 '어텐션(Attention)' 메커니즘과 '피드포워드 네트워크(FFN)'라는 두 가지 주요 하위 계층(Sub-Layer)으로 구성된다.
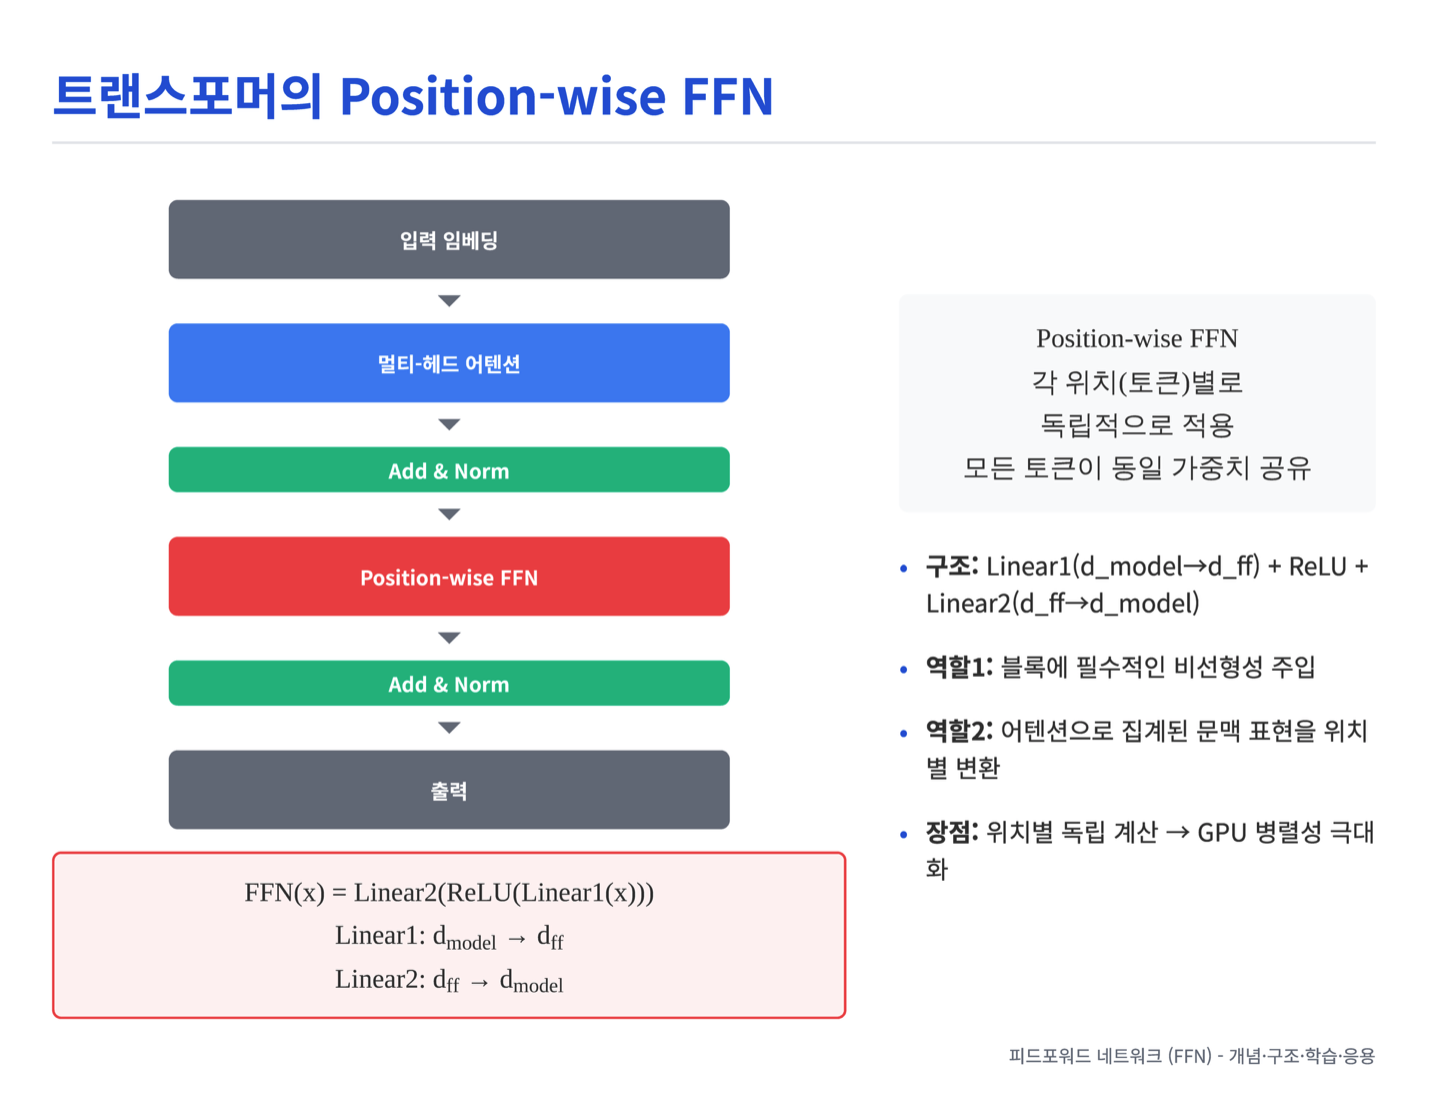
트랜스포머에 사용되는 FFN은 'Position-wise Feed-Forward Network'라고 불린다. 이 FFN은 보통 두 개의 선형(완전 연결) 레이어와 그 사이의 비선형 활성화 함수(주로 ReLU)로 구성된다. 일반적으로 첫 번째 레이어는 입력 차원을 크게 확장(ex: $d_model = 515$에서 $d_ff = 2048$)로 하고, 두 번째 레이어가 이를 다시 원래의 차원으로 축소시킨다.
이 FFN의 역할은 두 가지이다.
첫째, 어텐션 메커니즘이 주로 선형적인 행렬 연산으로 구성되어 있기 때문에, FFN은 트랜스포머 블록 전체에 필수적인 '비선형성(Non-Linearity)'을 주입하여 모델의 표현력을 높인다.
둘째, 어텐션을 통해 주변 토큰들의 정보를 집계하고 혼합한 '문맥적 표현'을 입력받아, 이를 각 토큰(position)별로 '처리'하고 '변환'하는 역할을 수행한다.
여기서 가장 중요한 특징은 'Position-wise'라는 이름에 있다. 이는 시퀀스 내의 모든 토큰(단어) 위치에 동일한 FFN(즉, 동일한 가중치 $W_1 , B_1 , W_2 , b_2$)이 적용되지만, 각각의 토큰마다 독립적으로(Independently) 계산이 수행된다는 의미이다. 100개의 토큰이 있다면, 100개의 토큰이 모두 어텐션 층을 통과한 뒤, 100개의 동일한 FFN이 100개의 토큰을 각각 동시에 병렬로 처리한다. 바로 이 지점에서 FFN의 오래된 한계(순차성 처리 불가)가 오히려 현대적 강점(병렬성)으로 재해석되었다.
RNN은 $H_t$를 계산하기 위해 $H_t-1$ 이 필요한 본질적인 '순차성' 때문에 GPU의 병렬 연산 능력을 극대화하기 어려웠다. 반면, 트랜스포머는 FFN의 '위치별 독립성'과 '어텐션의 동시 계산'을 활용하여 전체 시퀀스를 한 번에, 그리고 완벽하게 병렬처리할 수 있게 되었다.
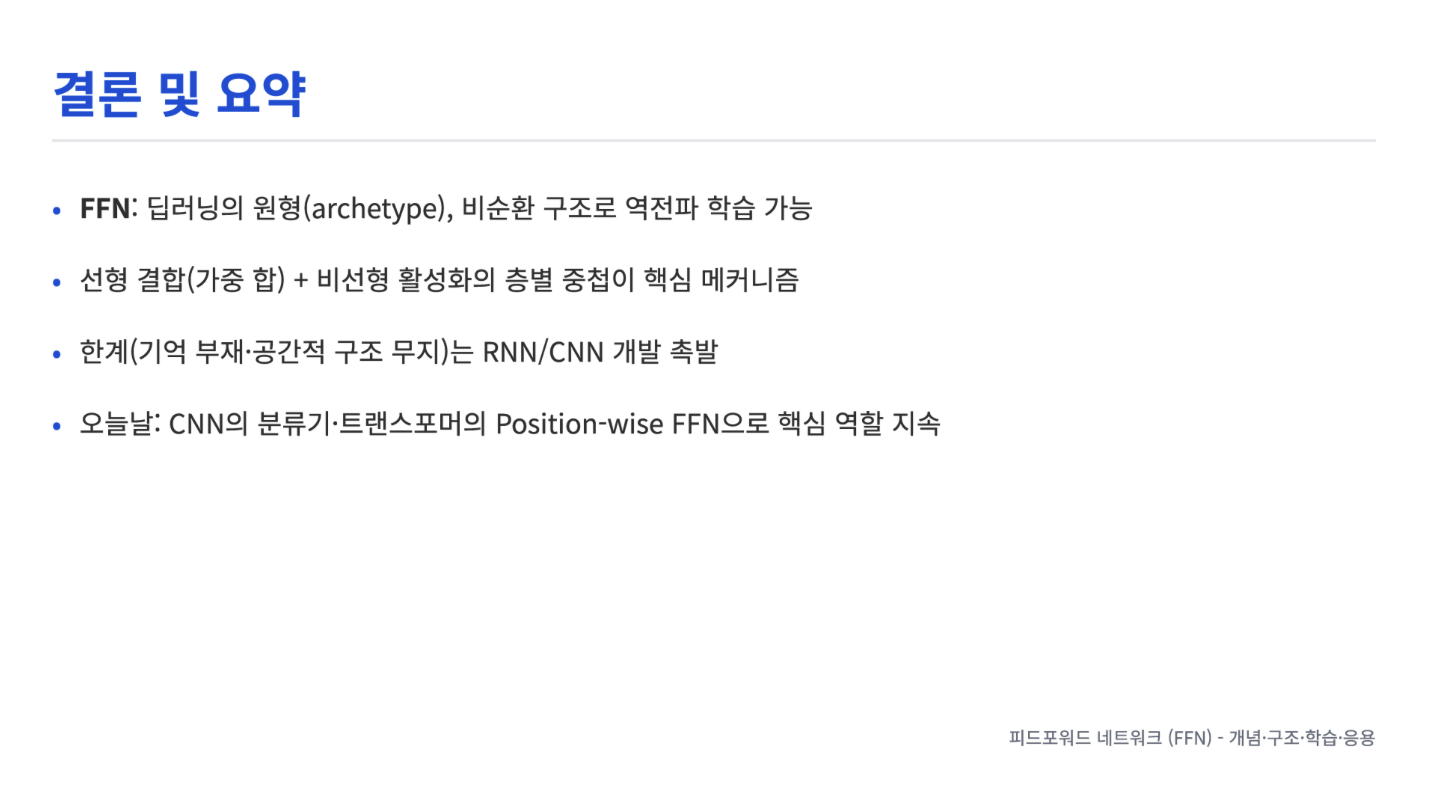
피드포워드 네트워크는 인공신경망의 역사에서 가장 근원적인 '원형(Archetype)'이자, 딥러닝의 기본 원리를 정의하는 교과서적 모델이다. 그 단순한 비순환적 구조는 역전파라는 강력한 학습 알고리즘을 적용하기 위한 필연적 선택이었으며, '선형 결합'과 '비선형 활성화'를 중첩하는 그 기본 메커니즘은 오늘날까지 이어지는 모든 딥러닝 아키텍쳐의 핵심 작동원리로 남아있다.
FNN의 본질적인 한계, 즉 '기억의 부재'와 '공간적 구조의 무지'는 역설적이게도 RNN과 CNN이라는 더 전문화된 아키텍쳐의 탄생을 촉발시킨 학문적 동력이 되었다.
그러나 FFN은 과거의 유물로 사라지지 않았다. 오히려 CNN의 최종 의사결정자로서, 그리고 트랜스포머의 심장부에서 'Position-wise FFN'이라는 핵심 병렬처리장치로서 그 중요성을 다시금 증명하고 있다.
피드포워드 네트워크는 딥러닝을 이해하기 위한 첫 번째 관문이자, 동시에 가장 복잡한 현대의 시스템을 구축하는 데에도 여전히 사용하는 마지막 필수 구성요소로서 그 항문적, 공학적 가치를 지속하고 있다.
https://blog.naver.com/simula/224078364231
피드포워드 네트워크(Feed-Forward Network, FFN)
피드포워드 네트워크(Feed-Forward Network, FFN)는 인공신경망 아키텍처 중 가장 기본이 되는 근간...
blog.naver.com
'AI : : ML-DL : : Data Science' 카테고리의 다른 글
| JEV(제브) (0) | 2026.09.21 |
|---|---|
| PersonaPlex를 구현해보기 (0) | 2026.04.17 |
| TFLite란 (0) | 2026.04.17 |
| ML에서 에포크(Epoch): 의미, 역할, 그리고 머신러닝에서 중요한 이유 (0) | 2026.02.04 |
| 영상 누끼 직접 따지 마세요! [펌글] (1) | 2024.11.06 |