앞서 살펴본 코드는 가독성이 좋고 알고리즘의 원리를 이해하기에는 완벽하지만, 상태(State)의 개수가 수천 개로 늘어나는 실전 음성 인식 환경에서는 속도가 매우 느려질 수 있습니다. 파이썬의 **딕셔너리(dict)**와 **루프(for)**는 유연하지만 수치 연산에서는 오버헤드가 크기 때문이죠.
효율성을 극대화하기 위한 4가지 핵심 최적화 방법을 제안해 드릴게요.
1. 벡터화 (Vectorization): 행렬 연산으로의 전환
1.1 Vectorization 소개
이는 CPU의 연산 부분(ALU)을 복사하여 붙여넣어 여러 연산 작업을 동시에 수행할 수 있도록 하는 것입니다.
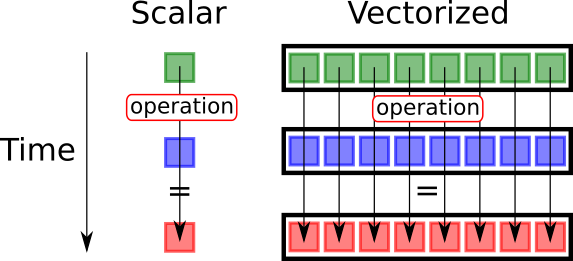
가장 드라마틱한 속도 향상을 가져오는 방법입니다. 파이썬의 for 문을 돌리는 대신, 모든 상태를 NumPy 행렬(Matrix)에 넣고 한 번에 계산하는 것이죠.
- 방법: 상태 간의 전이 확률을 행렬로 만들고, 현재 확률 벡터와 더합니다(로그 영역이므로 곱셈 대신 덧셈).
- 효과: 파이썬 루프 제어 오버헤드가 사라지고, 내부적으로 최적화된 C/C++ 코드가 실행됩니다.
다양한 벡터화 아키텍처가 존재합니다.
SSE2: 2개의 부동 소수점 단정밀도 연산을 동시에 수행
SSE4: 4개의 부동 소수점 단정밀도 연산을 동시에 수행
AVX: 8개의 부동 소수점 단정밀도 연산을 동시에 수행
AVX 512: 16개의 부동 소수점 단정밀도 연산을 동시에 수행
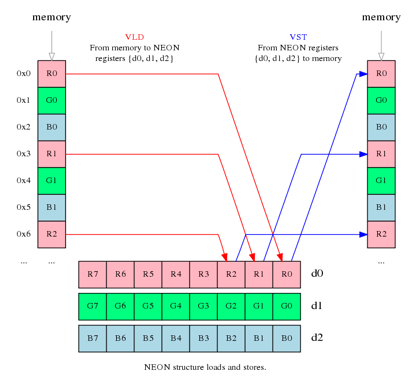
1.2 벡터화(Vectorization)과 SIMD의 비교
SIMD(Single Instruction, Multiple Data)와 Vectorization(벡터화)은 고성능 컴퓨팅에서 매우 밀접하게 연관된 개념이지만, 명확히 구분되는 층위(Layer)를 가지고 있습니다.
가장 핵심적인 차이는 SIMD는 '하드웨어 구조'이고, Vectorization은 그 하드웨어를 활용하기 위한 '소프트웨어 기법'이라는 점입니다.
이 두 가지의 상세 비교와 관계를 알기 쉽게 정리해 드립니다.
1.2.1 핵심 요약 (TL;DR)
| 비교 항목 | SIMD (Single Instruction, Multiple Data) | Vectorization (벡터화) |
| 정의 | 하나의 명령어로 여러 데이터를 동시에 처리하는 하드웨어 아키텍처(구조). | 스칼라(Scalar) 코드를 SIMD 명령어로 변환하여 병렬 처리를 수행하는 프로그래밍 기법/과정. |
| 계층 | Hardware Level (CPU 기능) | Software Level (컴파일러/코드) |
| 구성 요소 | 벡터 레지스터(XMM, YMM, ZMM), 명령어 세트(SSE, AVX, NEON). | Loop Unrolling, 데이터 정렬, 컴파일러 최적화 플래그, 벡터 라이브러리. |
| 역할 | 실제로 병렬 연산을 수행하는 주체. | 프로그램을 SIMD 하드웨어가 실행할 수 있는 형태로 만드는 행위. |
1.2.2 상세 개념 비교
SIMD (하드웨어 관점)
SIMD는 컴퓨터 구조에서 Flynn의 분류 중 하나로, 병렬 처리를 위한 하드웨어적 설계를 말합니다.
- 작동 원리: 일반적인 CPU가 한 번에 하나의 숫자(Scalar)만 더할 수 있다면, SIMD를 지원하는 CPU는 매우 긴 레지스터(예: 256-bit, 512-bit)를 사용하여 한 번에 4개, 8개, 혹은 16개의 숫자를 동시에 연산합니다.
- 예시: Intel의 AVX-512, ARM의 NEON 등이 대표적인 SIMD 명령어 세트입니다.
Vectorization (소프트웨어 관점)
Vectorization은 프로그래머나 컴파일러가 "한 번에 하나씩 처리하던 반복문"을 "한 번에 여러 개씩 처리하도록(SIMD를 사용하도록)" 코드를 재구성하는 과정입니다.
- 작동 원리: for (i=0; i<4; i++) c[i] = a[i] + b[i]라는 코드가 있을 때, 이를 4번 반복하는 대신 한 번의 SIMD 명령어로 처리하도록 변환합니다.
- 구현 방식:
- Auto-Vectorization: 컴파일러(GCC, Clang, MSVC)가 알아서 최적화 (-O2, -O3 옵션 등).
- Explicit Vectorization: 프로그래머가 직접 SIMD 내장 함수(Intrinsics)를 사용하거나 벡터 라이브러리(NumPy 등)를 사용.
1.2.3 스칼라 vs 벡터화 처리 과정 비교
이해를 돕기 위해 4개의 데이터 쌍 $(A_1, A_2, A_3, A_4)$와 $(B_1, B_2, B_3, B_4)$를 더하는 과정을 비교해 보겠습니다.
A. 스칼라 처리 (Non-Vectorized)
전통적인 방식은 순차적으로 처리합니다. (총 4클럭 소요 가정)
- Load $A_1$, Load $B_1$, Add, Store
- Load $A_2$, Load $B_2$, Add, Store
- Load $A_3$, Load $B_3$, Add, Store
- Load $A_4$, Load $B_4$, Add, Store
B. 벡터화 처리 (Vectorized using SIMD)
데이터를 팩(Pack)으로 묶어서 한 번에 처리합니다. (총 1클럭 소요 가정)
- Load Vector $A_{[1..4]}$, Load Vector $B_{[1..4]}$, Vector Add, Store Vector
수식적 표현:
스칼라 연산이 $C_i = A_i + B_i$를 $N$번 수행한다면,
벡터 연산은 $\vec{C} = \vec{A} + \vec{B}$를 $N/k$번 수행합니다. ($k$는 벡터 레지스터가 담을 수 있는 데이터 개수)
1.2.4 Vectorization을 구현하는 방법들
SIMD 하드웨어를 활용하기 위해(즉, Vectorization을 하기 위해) 개발자가 선택할 수 있는 방법은 다음과 같습니다.
- 라이브러리 사용 (가장 쉬움):
- Python의 NumPy, C++의 Eigen이나 OpenCV 같은 라이브러리는 내부적으로 이미 고도로 최적화된 Vectorization 코드를 사용합니다.
- 예: Python에서 c = a + b (배열 덧셈)를 하면 내부적으로 SIMD가 돕니다.
- 컴파일러 자동 벡터화 (Auto-Vectorization):
- 컴파일러에게 최적화 옵션을 주면, 컴파일러가 코드를 분석하여 가능한 부분(주로 루프)을 SIMD 명령어로 바꿉니다.
- 단, 데이터 의존성(Data Dependency)이 있거나 코드가 복잡하면 컴파일러가 포기할 수 있습니다.
- 컴파일러 지시어 (Pragma/Directives):
- #pragma omp simd (OpenMP) 처럼 개발자가 컴파일러에게 "이 루프는 안전하니 강제로 벡터화해라"라고 지시합니다.
- Intrinsics / Assembly (가장 어려움):
- C/C++에서 _mm256_add_ps 와 같은 하드웨어별 내장 함수를 직접 호출하여 코딩합니다. 성능은 최고지만 이식성이 떨어지고 작성이 어렵습니다.
1.2.5 요약 및 결론
- SIMD는 도구(하드웨어)입니다. (예: 4개의 못을 동시에 박을 수 있는 망치)
- Vectorization은 기술(소프트웨어)입니다. (예: 그 망치를 사용하여 실제로 4개의 못을 한 번에 박는 작업 방식)
따라서:
우리는 프로그램의 속도를 높이기 위해 Vectorization을 수행하며, 그 결과물은 CPU의 SIMD 유닛에 의해 실행됩니다.
2. 로그 확률의 사전 계산 (Pre-calculating Logs)
매 단계마다 np.log()를 호출하는 것은 매우 비싼 연산입니다.
- 방법: 루프에 진입하기 전에 전이 확률()과 출력 확률() 행렬 전체에 미리 로그를 취해 둡니다.
- 효과: 루프 내부에서는 단순한 덧셈 연산만 남게 되어 연산 속도가 비약적으로 상승합니다.
3. 효율적인 프루닝: 정렬(sorted) 대신 argpartition
3.1 프루닝, 빔 프루닝, 빔 서치 프루닝
프루닝(Pruning), 빔 프루닝(Beam Pruning), 빔 서치 프루닝(Beam Search Pruning)은 모두 인공지능, 특히 탐색(Search)이나 모델 최적화 분야에서 "불필요한 것을 잘라내어 효율성을 높인다"는 공통점이 있지만, 적용되는 문맥과 방식에 미묘한 차이가 있습니다.
이 용어들은 주로 자연어 처리(NLP)나 음성 인식의 디코딩(Decoding) 과정에서 혼용되어 쓰이는데, 명확한 개념 구분을 위해 아래와 같이 정리해 드립니다.
빔 서치에 대한 간략한 복습
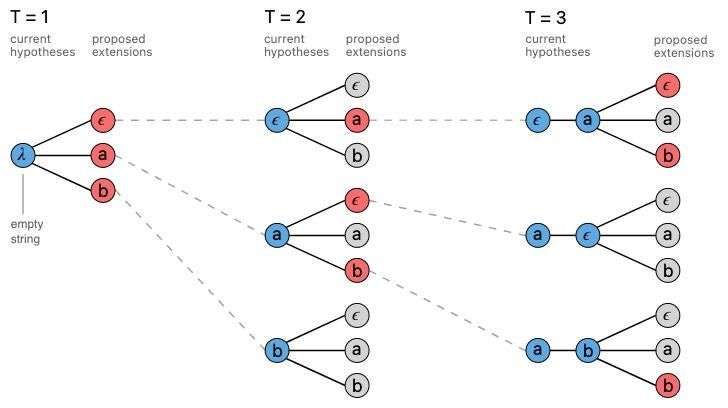
음성 및 언어 환경에서 빔 서치는 연속적인 값(예: 확률 또는 점수)의 시퀀스를 그래프 또는 시퀀스(예: 토큰, 단어 조각, 단어)로 변환하는 효율적인 탐욕 알고리즘입니다. 이 알고리즘은 유효한 시퀀스에 대한 제약 조건(예: 어휘집), 외부 점수 계산(예: 유효한 시퀀스에 점수를 매기는 언어 모델), 그리고 특정 시퀀스에 대한 점수 조정 등을 선택적으로 사용할 수 있습니다.
아래 그림은 토큰 집합 {ϵ, a, b}이며, ϵ은 단어 사이의 공백이나 발화 시 일시 정지를 나타내는 특수 토큰입니다. 아래 그림은 Awni Hannun의 distill.pub에 있는 CTC 및 빔 서치 관련 훌륭한 글에서 발췌했습니다.
3.1.1 핵심 요약 (TL;DR)
| 용어 | 핵심 개념 | 비유 | 작동 방식 (주로) |
| Pruning (가지치기) | 대분류 개념. 불필요한 경로/가중치를 제거하는 모든 행위. | 나무에서 죽은 가지를 전부 자르기. | 임계값 미만 제거, 0으로 만들기 등. |
| Beam Search (빔 탐색) | 알고리즘. 매 단계에서 상위 $K$개만 남기고 나머지는 다 버리는 탐색 기법. | 오디션에서 매 라운드 상위 3명만 합격시키기. | Top-K (개수 제한) 방식. |
| Beam Pruning (빔 프루닝) | 세부 기법. 빔 서치 내부에서, 최고 점수와 비교해 점수 차이가 큰 후보를 버리는 것. | 오디션에서 1등 점수가 90점일 때, 80점 미만은 인원수 상관없이 탈락시키기. | Threshold (점수 제한) 방식. |
3.1.2 상세 차이점 설명
(1) Pruning (가지치기 - 포괄적 개념)
가장 넓은 의미의 용어입니다. 탐색 공간(Search Space)이나 신경망 모델의 크기를 줄이는 모든 행위를 통칭합니다.
- 문맥 1 (탐색/Search): 정답일 확률이 낮은 경로를 아예 탐색하지 않고 잘라버리는 것. (예: AlphaGo의 MCTS 가지치기)
- 문맥 2 (모델 경량화): 신경망에서 중요도가 낮은 가중치(Weight)를 0으로 만들거나 뉴런을 제거하여 모델을 가볍게 만드는 기술.
- 특징: "무엇을 버린다"는 행위 자체를 의미합니다.
(2) Beam Search (빔 서치 - Top-K 알고리즘)
Pruning을 수행하는 가장 대중적인 탐색 알고리즘입니다. 모든 경우의 수를 다 보는 것(BFS)은 너무 느리고, 하나만 보는 것(Greedy)은 정확도가 떨어지므로, 그 중간 타협점을 찾습니다.
- 작동 방식: 매 타임스텝마다 모든 가능한 후보 중 확률이 가장 높은 **상위 K개(Beam Width)**만 남기고 나머지는 모두 버립니다(Pruning).
- 기준: 철저하게 개수(Width) 중심입니다. 1등과 꼴등의 점수 차이가 크든 작든 무조건 K개를 살립니다.
- 예시 (K=2):
- 후보: [A: 0.9], [B: 0.8], [C: 0.1], [D: 0.05]
- 결과: A, B 선택 (C, D는 잘림)
(3) Beam Pruning (빔 프루닝 - 점수 기반 컷팅)
이 용어는 빔 서치 알고리즘 내부에서 사용되는 특정 필터링 기법을 말할 때 주로 쓰입니다. (특히 음성 인식 엔진인 Kaldi 등에서 엄밀하게 구분합니다.)
- 작동 방식: 단순히 개수(K)로 자르는 게 아니라, 현재 가장 높은 점수를 가진 후보(Best Path)와 비교하여 일정 점수(Threshold/Delta) 이상 차이가 나는 후보를 버립니다.
- 기준: 점수 차이(Score Difference) 중심입니다.
- 왜 필요한가?
- Beam Search(Top-K)의 단점은, 후보들이 다 고만고만하게 안 좋은데도 억지로 K개를 채워서 가져가거나, 반대로 모두가 훌륭한데 K개라서 아깝게 버리는 경우가 생깁니다.
- Beam Pruning은 "1등이랑 점수 차이가 너무 심하면, Top-K 안에 들어도 가망 없으니 버려라"는 식의 로직입니다.
- 예시 (Threshold=0.2):
- 상황: 1등(Best) 점수가 0.9임. (커트라인: $0.9 - 0.2 = 0.7$)
- 후보: [A: 0.9], [B: 0.6], [C: 0.5]
- 결과: 빔 사이즈가 3이라도 B, C는 점수가 0.7보다 낮으므로 버려짐.
3.1.3 Beam Search Pruning이란?
이 용어는 사실 Beam Search와 혼용되어 쓰이거나, 위에서 설명한 **Beam Search + Beam Pruning(Thresholding)**을 합쳐서 부르는 말입니다.
보통 학술적이나 실무적으로는 다음과 같이 이해하면 가장 정확합니다.
"Beam Search Pruning" = Beam Search 알고리즘을 사용하여 탐색 공간을 줄이는(Pruning) 전체 과정.
구체적으로는:
- Histogram Pruning (Top-K): 상위 N개만 남김.
- Threshold Pruning (Beam Width): 최고 점수 대비 일정 범위 밖을 버림.
이 두 가지를 섞어서 쓰는 전략을 통칭하기도 합니다.
3.1.4 요약 다이어그램
graph TD
    A[Search Space (모든 경우의 수)] --> B{Pruning 기법 적용}

    B --> C[Greedy Search]
    C --> C1[무조건 1등만 선택]

    B --> D[Beam Search Algorithm]
    D --> E(후보군 생성)

    E --> F{어떻게 자를 것인가?}

    F -->|Top-K Pruning| G[개수 제한: 상위 K개만 남김]
    F -->|Threshold Pruning| H[점수 제한: 1등과 차이 큰 놈 버림]

    G --> I[다음 단계 진행]
    H --> I
3.1.5 결론
- 일반적인 대화에서 "빔 서치 쓴다"라고 하면, Top-K 방식(개수 제한)을 의미합니다.
- 좀 더 딥하게 최적화를 논할 때 "빔 프루닝을 타이트하게 잡았다"라고 하면, 점수 임계값(Threshold)을 조절하여 불필요한 계산을 더 줄였다는 뜻으로 이해하시면 됩니다.
3.2 프루닝: argpartition
프루닝과 빔 서치를 이야기할 때 argpartition은 실무적으로 굉장히 중요한 "가성비 도구"입니다. 빔 서치에서 상위 $K$개를 뽑을 때, 성능을 비약적으로 높여주는 핵심 함수이기 때문이죠.
간단히 말해, argpartition은 "완벽하게 정렬하지 않고, 딱 필요한 만큼만 솎아내는 기술"입니다.
3.2.1 왜 argpartition을 쓰는가?
우리가 빔 서치에서 상위 5개(Beam Width)의 후보를 찾으려 한다고 가정해 봅시다.
- 기존 방식 (argsort 또는 sort): 전교생 1,000명의 성적을 1등부터 1,000등까지 전부 줄 세운 뒤, 앞에서 5명을 뽑습니다.
- argpartition 방식: 1,000명 중 누가 5등 안에 드는지만 대충 분류(Partition)해서, 상위 그룹 5명만 따로 빼냅니다. 나머지 995명의 순서는 알 바 아닙니다.
3.2.2 알고리즘적 차이 ($O(N)$의 마법)
가장 큰 차이는 시간 복잡도에 있습니다.
- argsort (Full Sort): $O(N \log N)$의 시간이 걸립니다. 데이터가 많아질수록 정렬 비용이 기하급수적으로 늘어납니다.
- argpartition (Partial Sort): **$O(N)$**의 시간이 걸립니다. 전체를 정렬하지 않고 '피벗(Pivot)'을 기준으로 나누기만 하기 때문에 훨씬 빠릅니다.
빔 서치는 매 단계마다 이 작업을 반복해야 합니다. $N$(단어 사전의 크기)이 3만 개가 넘는 언어 모델에서 매번 전체 정렬을 하는 것은 엄청난 낭비죠. 이때 argpartition이 구세주가 됩니다.
3.2.3 어떻게 작동하나? (NumPy 예시)
argpartition(array, K)를 호출하면, 인덱스 $K$에 위치할 원소를 기준으로 배열을 두 그룹으로 나눕니다.
- 결과: 지정한 $K$번째 요소보다 작은 값은 왼쪽, 큰 값은 오른쪽으로 보내버립니다.
- 주의: 결과로 나온 상위 $K$개 내부에서는 순서가 보장되지 않습니다. (예: 90, 80, 50 순서가 아니라 50, 80, 90 순일 수도 있음). 만약 이 안에서도 순서가 중요하다면, 추출된 $K$개에 대해서만 따로 소규모 정렬을 하면 됩니다.
3.2.4 프루닝(Pruning)에서의 역할
빔 서치 프루닝 과정에서 argpartition은 다음과 같은 흐름으로 사용됩니다.
- 확률 계산: 다음 단어로 올 수 있는 30,000개 후보의 확률을 계산합니다.
- Top-K 추출: argpartition을 사용해 상위 5개(Beam Width)의 인덱스만 광속으로 찾아냅니다. (나머지 29,995개는 무시 = Pruning)
- 정교화 (선택): 뽑힌 5개 안에서만 다시 정렬하여 순위를 매깁니다.
- 반복: 다음 타임스텝으로 넘어갑니다.
3.2.5 요약하자면
- sort는 "모든 데이터의 서열을 정리하는 완벽주의자"이고,
- argpartition은 "필요한 놈들만 빠르게 골라내는 실용주의자"입니다.
프루닝은 결국 "버리는 작업"이 핵심인데, argpartition은 무엇을 버릴지 결정하는 가장 효율적인 필터링 도구라고 이해하시면 됩니다.
sorted() 함수는 전체를 정렬하느라 $O(N \log N)$의 시간이 걸립니다. 하지만 우리는 상위 개만 필요하죠.
- 방법: np.argpartition을 사용하면 상위 개 요소만 대략적으로 골라낼 수 있어 $O(N)$의 시간 복잡도로 프루닝이 가능합니다.
- 더 나은 방법: 특정 점수 차이(Beam Threshold) 이하를 한꺼번에 날려버리는 임계값 기반 프루닝을 쓰면 정렬 자체가 필요 없습니다.
4. 최적화된 코드 구조 (NumPy 기반)
이 방식들을 적용한 훨씬 빠른 비터비 서치 구조는 대략 다음과 같습니다.
5. 한단계 더 나아가기: Numba 또는 Cython
만약 NumPy 벡터화로도 부족하다면, 파이썬 코드를 기계어로 컴파일해주는 Numba 라이브러리를 사용해 보세요.
@njit 데코레이터 하나만 함수 위에 붙여도, 파이썬 루프가 C 언어 수준의 속도로 실행됩니다. 특히 비터비처럼 의존성이 강한 순차 루프에서 엄청난 성능을 발휘하죠.
💡 요약하자면
- 딕셔너리를 버리고 NumPy 배열을 쓰세요.
- log 연산은 딱 한 번만 미리 하세요.
- 루프 대신 행렬 연산(Broadcasting)을 활용하세요.
- 정말 극강의 속도가 필요하면 Numba로 컴파일하세요.
이런 최적화 기법들은 현대 음성 인식기나 실시간 번역 시스템에서 밀리초() 단위의 응답 속도를 확보하기 위해 필수적으로 쓰이는 테크닉들입니다.
다음에 해볼 만한 작업: 혹시 위에서 언급한 NumPy 브로드캐스팅(Broadcasting) 원리가 구체적으로 어떻게 행렬 연산을 처리하는지 궁금하신가요? 아니면 Numba를 실제로 적용해서 얼마나 빨라지는지 벤치마킹하는 법을 알아볼까요?
'AI : : ML-DL : : Data Science > : : ASR | NLP : :' 카테고리의 다른 글
| ASR: Conformer와 Whisper (0) | 2026.04.17 |
|---|---|
| Conformer, Whisper, Diffusion의 성능 향상을 위한 튜닝법 (0) | 2026.04.17 |
| [NLP] 빔 프루닝 (비터비 서치) (0) | 2026.02.02 |
| [NLP] 비터비(Viterbi) 알고리즘 (0) | 2026.02.02 |
| [SR] DP Matching (0) | 2026.02.02 |